Fiyat ve bütçe · 2026-09-22
Ling 3.0 Flash'ta prompt cache ile tekrarlanan sistem talimatının maliyetini düşürme
inclusionai/ling-3.0-flash'ın LLMTR gateway'i üzerinden çağrılırken cache okuma fiyatının girdi fiyatının beşte biri olduğunu ve bu farkın zaten düşük birim fiyatlı bir modelde hâlâ anlamlı bir tasarrufa dönüştüğü durumları anlatır.
Üç mevcut yazı self-hosting eksenindeydi, bu yazı LLMTR API'sine bakıyor
Bu modelle ilgili önceki üç yazı, Ling 3.0 Flash'ı kendi altyapınızda çalıştırmaya odaklanıyordu: Ollama/MLX ile yerel deneme, vLLM ile üretim ölçekli dağıtım ve reasoning_effort/tool-calling'in davranış mekaniği. Bu yazı farklı bir soruya bakıyor: modeli kendi altyapınızda değil, doğrudan LLMTR gateway'i üzerinden çağırıyorsanız, fiyat kartındaki cache okuma satırı toplam maliyeti nasıl etkiler?
Model, 124 milyar parametreli bir Mixture-of-Experts mimarisidir ve token başına yaklaşık 5,1 milyar parametre çalıştırır; LLMTR üzerinden girdi 1M token başına 0,06 dolar, çıktı 0,18 dolardan faturalanır. Bu, katalogdaki en düşük birim fiyatlı modellerden biridir — bu yüzden 'zaten bu kadar ucuzken cache'i kim önemser' sorusu akla gelebilir; aşağıdaki bölüm bunu sayılarla cevaplıyor.
Cache okuma, girdi fiyatının beşte biri
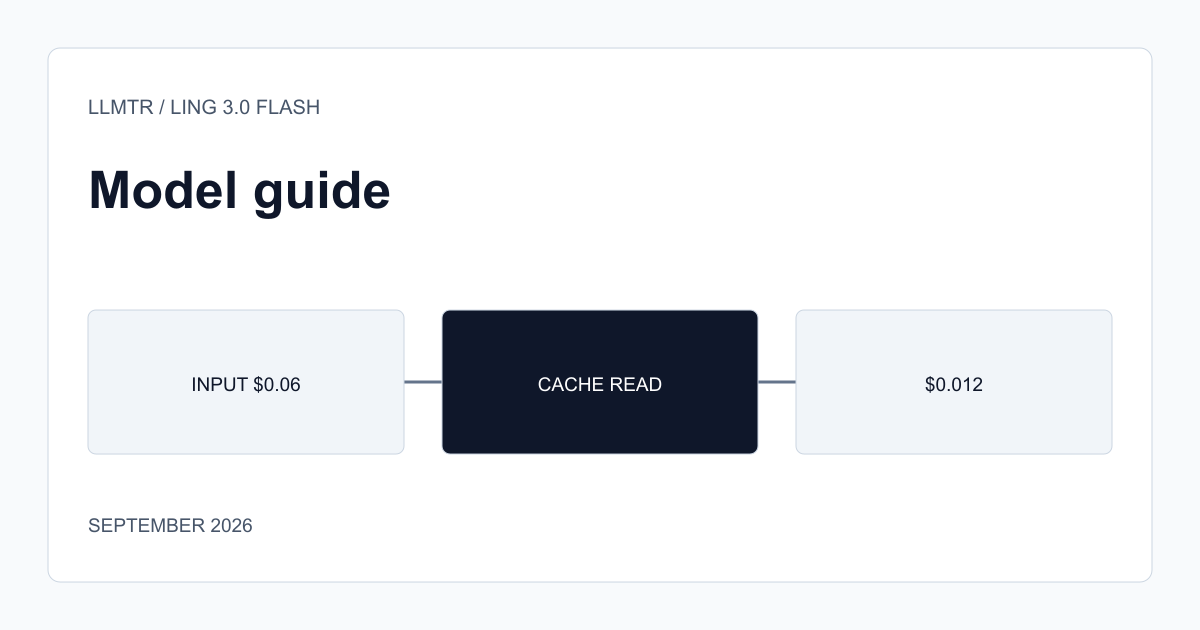
Fiyat kartı, önbellekten okunan girdi tokenlarının 1M başına 0,012 dolardan faturalandığını gösterir — normal girdi fiyatının (0,06$) tam beşte biri. Bu oran, modelin kendisi zaten ucuz olsa da, tekrarlanan bir sistem talimatı veya sabit bir bağlam öneki taşıyan yüksek hacimli bir akışta hâlâ anlamlı bir tasarruf demektir.
Örneğin, her istekte 2.000 token'lık sabit bir sistem talimatı gönderen bir ajan akışında, bu önek önbellekten okunduğunda istek başına maliyet yaklaşık 0,00012$'dan 0,000024$'a düşer; tek istek başına bu fark küçük görünse de, günde yüz binlerce istek gönderen bir üründe toplam fatura üzerinde ölçülebilir bir etki bırakır.
- Cache okuma fiyatı: 1M token başına 0,012$ (normal girdinin beşte biri).
- Sabit bir sistem talimatı veya doküman öneki tekrar tekrar gönderiliyorsa cache devreye girer.
- Düşük birim fiyatlı bir modelde bile yüksek hacimde bu oran toplamda anlamlı kalır.
Cache ne zaman devreye girmez
Önbellek, önceki bir istekle örtüşen bir önek gerektirir; her isteğin içeriği baştan sona farklıysa (örneğin her seferinde tamamen farklı bir kullanıcı sorusu ve farklı bir bağlam belgesi), önbellekten yararlanacak bir tekrar yoktur ve tüm girdi normal fiyattan faturalanır. Bu durumda cache'in fiyat avantajı teorik kalır, pratik bir kazanç sağlamaz.
Modelin varsayılan olarak açık olan düşünme (reasoning) davranışı da ayrı bir maliyet kalemidir; reasoning tokenları çıktı olarak faturalanır ve cache'in kapsamı dışındadır. Kısa, kesin yanıt gerektiren isteklerde `reasoning_effort: "none"` göndermek (bu modelde etkili olan tek kapatma seviyesi), cache stratejisinden bağımsız olarak toplam maliyeti düşürür.
Sık sorulan sorular
Cache okuma fiyatı çıktı tokenları için de geçerli mi?
Hayır, fiyat kartındaki cache okuma satırı yalnızca girdi tarafındaki tekrarlanan önek için geçerlidir; çıktı tokenları (reasoning dahil) her zaman normal çıktı fiyatından faturalanır.
Bu model zaten çok ucuzken cache stratejisi kurmaya değer mi?
Düşük hacimli bir kullanım için fark ihmal edilebilir olabilir; ama sabit bir talimat/doküman önekini yüksek hacimde tekrar gönderen bir üretim akışında, beşte birlik oran toplam faturada ölçülebilir bir tasarrufa dönüşür.