Entegrasyon rehberleri · 2026-10-30
Tayca, Endonezce, Vietnamca ve Malayca için dil modeli API'si
Qwen-SEA-LION-v4.5-27B-IT'yi LLMTR'de Tayca, Endonezce, Vietnamca ve Malayca destek cevabı, çeviri ve özet için kullanın: diller, fiyat ve sınırlar.
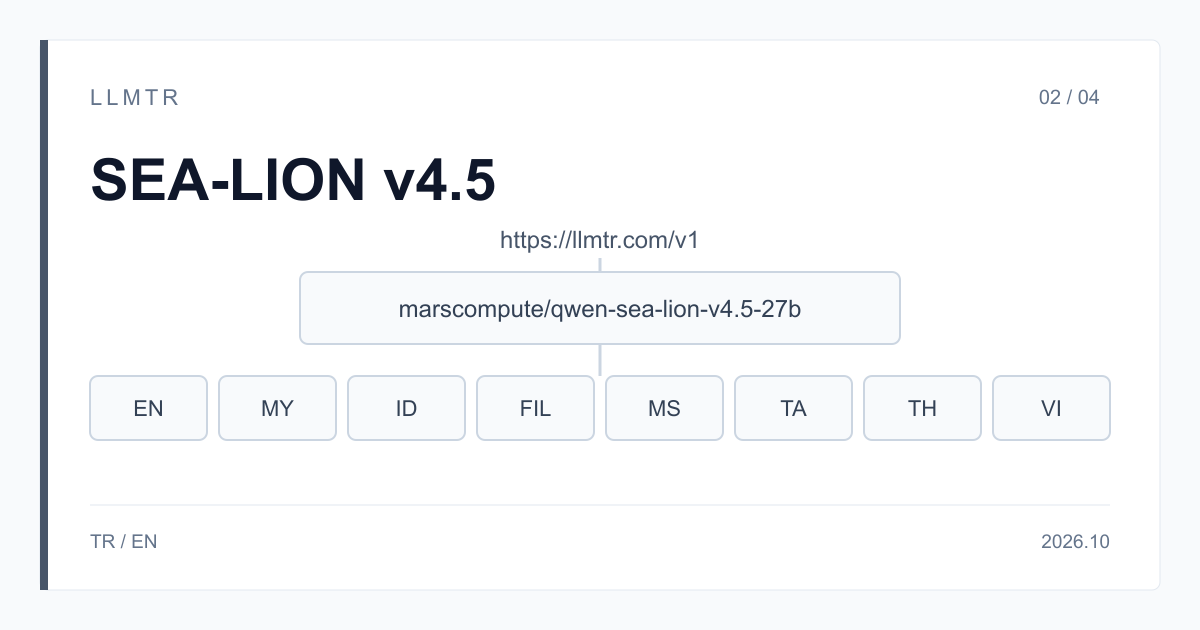
Kısa yanıt: Güneydoğu Asya dilleri için Qwen-SEA-LION-v4.5-27B-IT
LLMTR, farklı sağlayıcıların dil modellerine tek bir OpenAI uyumlu API ile erişim veren bir gateway'dir. Tayca, Endonezce, Vietnamca ya da Malayca metinle çalışan bir uygulama için LLMTR'de AI Singapore'un Qwen-SEA-LION-v4.5-27B-IT modelini marscompute/qwen-sea-lion-v4.5-27b kimliğiyle, https://llmtr.com/v1 adresindeki /v1/chat/completions uç noktasından çağırabilirsiniz; llmtr.com hesabınızın API anahtarı yeterlidir. Model LLMTR'de MarsCompute tarafından sunulur ve 1 milyon token başına 0,60 $ girdi, 3,60 $ çıktıdır.
SEA-LION, Southeast Asian Languages In One Network'ün kısaltmasıdır ve AI Singapore'un Güneydoğu Asya dilleri için geliştirdiği model ailesinin adıdır. Qwen-SEA-LION-v4.5-27B-IT, bu ailenin Qwen3.6-27B üzerine eğitilmiş, MIT lisanslı talimat modelidir. Model kartına göre eğitim sonrası aşama İngilizce ve Güneydoğu Asya dillerinde yapılmıştır. Türkçe desteklenen diller arasında değildir; Türkçe metin için bu modeli seçmeyin.
Tayca, Endonezce, Vietnamca ya da Malayca metin için API ile hangi model kullanılır?
Bu dillerden biriyle çalışıyorsanız, yapımcısının o dili açıkça saydığı bir modelle başlamak işi kolaylaştırır. Qwen-SEA-LION-v4.5-27B-IT'nin model kartı İngilizcenin yanında yedi Güneydoğu Asya dilini sayar. Tablo bu sekiz dili yaygın dil kodlarıyla, 30 Ekim 2026 itibarıyla model kartının metnine göre gösterir; son satır Türkçedir.
Kart dillerin listesini verir, her dilde sonucun nasıl olduğunu söylemez; bu yazı da söylemez. Modeli kendi metinlerinizle deneyin: gerçek müşteri mesajlarınızdan ve belgelerinizden birkaç örnek seçin ve cevapları o dili ana dili olarak konuşan biriyle kontrol edin. Aynı işi iki dilde yapıyorsanız iki dili ayrı ayrı deneyin; bir dildeki sonuç ötekini göstermez.
| Dil | Dil kodu | Model kartında |
|---|---|---|
| İngilizce | en | evet |
| Birmanca | my | evet |
| Endonezce | id | evet |
| Filipince | fil | evet |
| Malayca | ms | evet |
| Tamilce | ta | evet |
| Tayca | th | evet |
| Vietnamca | vi | evet |
| Türkçe | tr | hayır, desteklenen diller arasında değil |
Hangi işlerde kullanılır: destek cevabı, çeviri ve özet
Aşağıdaki işler modelin metin girip metin çıkan yapısına ve 8.192 token'lık penceresine uyar. Her birinde talimatı sistem mesajına, işlenecek metni kullanıcı mesajına koyun:
- Müşteri desteği: Tayca ya da Malayca gelen bir mesaja aynı dilde kısa bir cevap taslağı. Sistem mesajına şirketinizin kurallarını, cevabın uzunluğunu ve tonunu yazın; taslağı müşteriye göndermeden önce bir temsilci kontrol etsin.
- Çeviri: Endonezce ya da Vietnamca bir metni İngilizceye, İngilizce bir metni bu dillere çevirmek. Kaynak ya da hedef dil olarak Türkçe kullanmayın; Türkçe bu modelin dilleri arasında değildir.
- Özet: Vietnamca bir rapordan ya da Filipince bir toplantı notundan birkaç cümlelik bir özet. 8.192 token'a sığmayan bir metni önce parçalara bölün ve her parçayı ayrı istekle özetletin.
- Sınıflandırma: Endonezce müşteri yorumlarını olumlu, olumsuz ya da nötr diye etiketlemek. Cevabı tek kelime olarak istemek için talimatı sistem mesajına yazın ve max_tokens'ı küçük tutun.
Kod: üç dilde üç istek
Python örneği aynı istemciyle üç istek gönderir: Tayca bir müşteri mesajına cevap taslağı, Endonezce iki cümlenin İngilizce çevirisi ve Vietnamca bir notun özeti. Talimatlar İngilizcedir, metinler kendi dillerindedir. Her istekte max_tokens 300'dür; usage alanı her isteğin token sayısını verir ve örnek tutarı bu sayılardan, kataloğun 30 Ekim 2026 fiyatıyla hesaplar. JSON çıktı gerekiyorsa response_format göndermeyin, bu satırda 400 döner; biçimi talimatta tarif edin, örneğin her sonucu ayrı bir satırda isteyin.
Tayca destek cevabı, Endonezceden İngilizceye çeviri ve Vietnamca özet için Qwen-SEA-LION-v4.5-27B-IT'ye https://llmtr.com/v1/chat/completions üzerinden üç istek gönderen OpenAI Python SDK örneği.
import os

from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])
MODEL = "marscompute/qwen-sea-lion-v4.5-27b"

# Per 1M tokens on 30 October 2026: (input, cache read, output); None = no cache price.
PRICES = {"marscompute/qwen-sea-lion-v4.5-27b": (0.60, None, 3.60)}
INPUT, _, OUTPUT = PRICES[MODEL]

# (instruction, text): instructions in English, texts in their own language.
TASKS = {
    "support_th": (
        "You are a support agent. Reply in Thai, politely, in at most three sentences.",
        "สินค้าที่สั่งเมื่อวันจันทร์ยังไม่ได้รับเลยค่ะ ช่วยตรวจสอบให้หน่อยได้ไหมคะ",
    ),
    "translate_id_en": (
        "Translate the text into English. Return only the translation.",
        "Pengiriman Anda akan tiba dalam dua hari kerja. Terima kasih atas kesabaran Anda.",
    ),
    "summary_vi": (
        "Summarise the note in Vietnamese in two sentences.",
        "Cuộc họp sáng nay thống nhất dời ngày ra mắt sản phẩm sang tháng sau để hoàn thiện bản dịch tiếng Thái và tiếng Indonesia.",
    ),
}

for name, (instruction, text) in TASKS.items():
    response = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "system", "content": instruction}, {"role": "user", "content": text}],
        max_tokens=300,
    )
    usage = response.usage
    cost = (usage.prompt_tokens * INPUT + usage.completion_tokens * OUTPUT) / 1_000_000
    print(name, response.choices[0].message.content, usage.prompt_tokens, usage.completion_tokens, f"${cost:.6f}")
Maliyet: fiyat aynı, token sayısı dile göre değişir
Fiyat dile göre değişmez: 1 milyon token başına 0,60 $ girdi ve 3,60 $ çıktıdır ve önbellek indirimi yoktur. Değişen şey aynı içeriğin kaç token tuttuğudur; aynı anlamdaki iki cümle iki dilde farklı sayıda token'a bölünebilir. Bu yüzden tahminleri yanıttaki usage alanından okuyun ve kendi metinlerinizin ortalamasını çıkarın.
Örnek: 1.000 token'lık Tayca bir müşteri mesajına 300 token'lık bir cevap 0,0006 $ girdi ve 0,00108 $ çıktı eder; istek toplam 0,00168 $ tutar. Böyle 1.000 mesaj 1,68 $ eder. 2.000 token'lık Endonezce bir metnin İngilizce çevirisi de yaklaşık 2.000 token çıktı üretirse istek 0,0084 $ tutar. Çevirinin uzunluğu kaynağa bağlı olduğundan bu işte toplamın büyük kısmını çıktı oluşturur.
Türkçe çalışan bir ekip için notlar
Türkçe desteklenen diller arasında olmadığı için talimatları İngilizce ya da hedef dilde yazın. Türkçe bir metni doğrudan Tayca ya da Endonezceye çevirmek bu model için uygun bir iş değildir; önce metni İngilizceye çeviren ayrı bir adım kurun ya da Türkçeyi destekleyen başka bir model kullanın. LLMTR kataloğundaki modelleri aynı API anahtarıyla çağırabilirsiniz; çoğu zaman yalnızca model alanını değiştirmeniz yeterlidir.
Pencere 8.192 token'dır ve istem metni yaklaşık 32.000 karakteri geçemez. Konuşma geçmişini her istekte yeniden gönderen bir destek uygulamasında eski mesajları kırpın ya da kısa bir özetle değiştirin; istem büyüdükçe max_tokens için kalan yer azalır. Araç çağrısı, JSON response_format ve görsel bu satırda desteklenmez ve 400 döner. Akış (stream) desteklenir; uzun cevaplarda metni üretildikçe gösterebilirsiniz.
Qwen-SEA-LION-v4.5-27B-IT ile Güneydoğu Asya dilinde ilk iş
Bir API anahtarı oluşturun, talimatı İngilizce ya da hedef dilde yazın ve marscompute/qwen-sea-lion-v4.5-27b'ye kendi metinlerinizle bir istek gönderin.
- Anahtar. llmtr.com'da bir API anahtarı oluşturun ve Panel > Faturalandırma'dan bakiye yükleyin.
- Talimat. Talimatı sistem mesajına İngilizce ya da hedef dilde yazın, metni kullanıcı mesajına koyun ve max_tokens ile https://llmtr.com/v1/chat/completions uç noktasına gönderin.
- Kontrol. Cevabı o dili ana dili olarak konuşan biriyle kontrol edin ve usage alanındaki token sayılarından tutarı hesaplayın.
Sık sorulan sorular
Qwen-SEA-LION-v4.5-27B-IT hangi dilleri destekler?
Model kartı İngilizce, Birmanca, Endonezce, Filipince, Malayca, Tamilce, Tayca ve Vietnamcayı sayar. Türkçe desteklenen diller arasında değildir.
Tayca bir destek cevabı ne tutar?
1.000 token'lık bir mesaja 300 token'lık bir cevap 0,00168 $ tutar. Fiyat 1 milyon token başına 0,60 $ girdi ve 3,60 $ çıktıdır.
Çeviri sonuçlarını JSON olarak alabilir miyim?
response_format ile hayır; istek 400 döner. Biçimi talimatta tarif edin, örneğin her çeviriyi ayrı bir satırda ya da numaralı bir liste olarak isteyin.