RAG ve veri · 2026-09-22
Voyage Rerank 2.5 ile iki aşamalı retrieval'ın maliyetini hesaplama
Bir RAG hattında embedding ile ilk adayları çekip Voyage Rerank 2.5 ile yeniden sıralamanın toplam token maliyetinin nasıl hesaplandığını ve bunun dil modeline gönderilen token sayısını nasıl düşürdüğünü anlatır.
Rerank neden embedding'den farklı bir isabet sağlar
Embedding araması hız için sorguyu ve her dokümanı ayrı ayrı vektörleştirir; bu, milyonlarca doküman arasında hızlı bir ilk tarama yapmayı mümkün kılar ama sorgu ile doküman arasındaki ince anlamsal ilişkiyi bazen kaçırır. Voyage Rerank 2.5, sorgu ile her aday dokümanı BİRLİKTE okuyup bir alaka puanı üretir; bu, daha isabetli bir sıralama verir ama her aday için ayrı bir değerlendirme gerektirdiğinden embedding'den daha maliyetlidir.
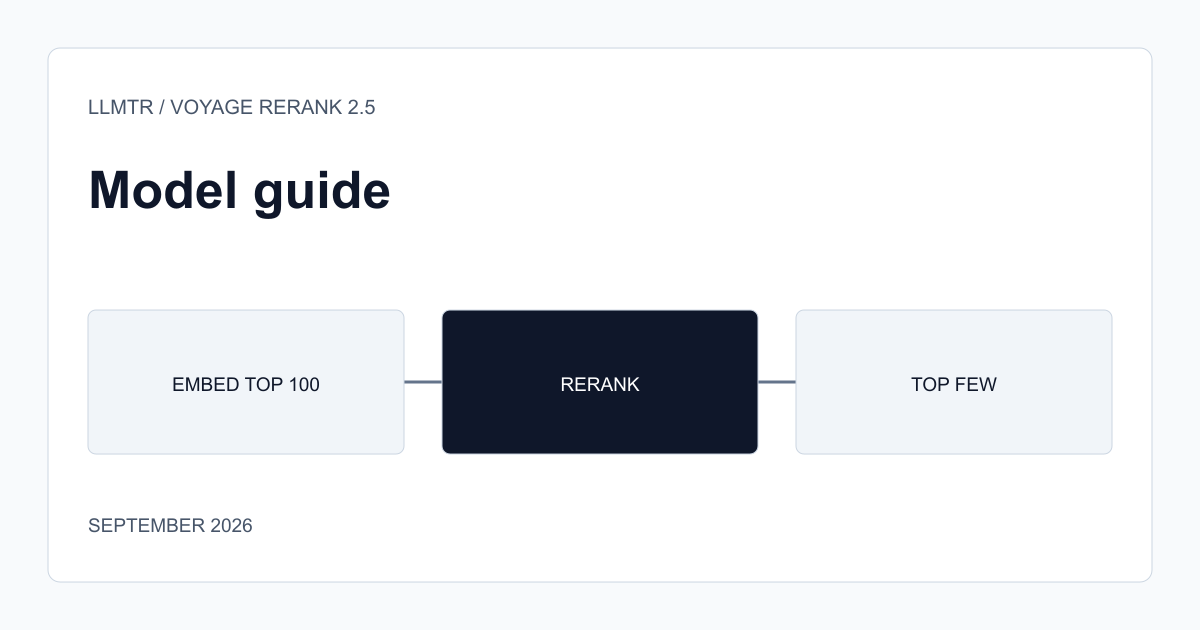
Bu yüzden tipik desen, önce embedding ile ucuz ve hızlı bir ilk tarama yapıp adayları 50-100'e indirmek, ardından bu küçük kümeyi rerank ile yeniden sıralamaktır; tüm koleksiyonu doğrudan rerank etmek maliyeti gereksiz yere yükseltir.
Maliyet formülü: sorgu x doküman sayısı + doküman token toplamı
Model sayfası, ücretlendirmenin işlenen toplam token üzerinden yapıldığını belirtir: (sorgu token sayısı × değerlendirilen doküman sayısı) + tüm dokümanların token toplamı. Bu, sorgunuz uzunsa ve çok sayıda dokümanı rerank ediyorsanız ilk terimin hızla büyüdüğü, kısa bir sorgu ile az sayıda dokümanı rerank ederken ise maliyetin doküman token toplamına yaklaştığı anlamına gelir.
Tek bir istekte en fazla 1000 doküman değerlendirilir; embedding aşamasında ilk taramayı 50-100 adaya indirmek yalnızca isabeti artırmakla kalmaz, sorgu tekrarının çarpıldığı doküman sayısını da düşürüp rerank maliyetini kontrol altında tutar.
- Maliyet = (sorgu token × doküman sayısı) + doküman token toplamı.
- Embedding ile aday sayısını 50-100'e indirmek rerank maliyetini kontrol eder.
- Tek istekte en fazla 1000 doküman değerlendirilir.
Asıl tasarruf dil modeli tarafında görülür
Rerank'in maliyeti embedding'den yüksek olsa da, dil modeline yalnızca en alakalı birkaç dokümanı göndermek, üretim modelinin işlediği toplam token sayısını (ve dolayısıyla üretim modelinin maliyetini) düşürür. Rerank aşamasının kendi maliyetini, üretim modelinde tasarruf ettiğiniz token maliyetiyle birlikte değerlendirmek, tek başına rerank fiyatına bakmaktan daha doğru bir tablo verir.
Sık sorulan sorular
Rerank'i embedding olmadan tek başına kullanabilir miyim?
Teknik olarak evet, ama tüm koleksiyonu rerank etmek (sorgu token × koleksiyon boyutu) formülü nedeniyle hızla maliyetli hale gelir; embedding ile önce daraltmak önerilir.
1000 doküman sınırını aşan bir aday kümesi nasıl işlenir?
Tek bir istekte en fazla 1000 doküman değerlendirilir; daha büyük bir aday kümeniz varsa embedding aşamasında daha sıkı bir ön filtre uygulayıp kümeyi bu sınırın altına indirmeniz gerekir.