Flujos de agentes · 2026-10-10
Verificar la salida de un agente: probabilidades de Perplexity Decider en lugar de un juez que escribe texto
Revisa la respuesta de un agente con probabilidades de sí/no de perplexity/pplx-decider-v1.1-27b antes de enviarla: umbrales, revisión humana y coste.
Respuesta corta: revisa la respuesta con probabilidades de sí/no antes de enviarla
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. Para revisar la salida de un agente llamas a perplexity/pplx-decider-v1.1-27b en el endpoint https://llmtr.com/v1/systemone; la dirección base es https://llmtr.com/v1. Envías la pregunta del usuario, el resultado de la herramienta y la respuesta del agente como estado, y conviertes tu lista de control en preguntas noul. Cada pregunta devuelve una probabilidad de sí entre 0 y 1, y la entrada cuesta 0,02 $ por 1M de tokens.
Con un modelo juez que escribe texto, el veredicto hay que extraerlo de una frase: el formato puede cambiar, se añaden explicaciones, el JSON puede quedar cortado. Decider no genera texto; devuelve solo una probabilidad por pregunta y tu código aplica el umbral. A cambio, no escribe una justificación. Si necesitas saber por qué una respuesta salió baja, eso es otro paso.
Cómo verificar la salida de un agente con probabilidades en lugar de un juez LLM
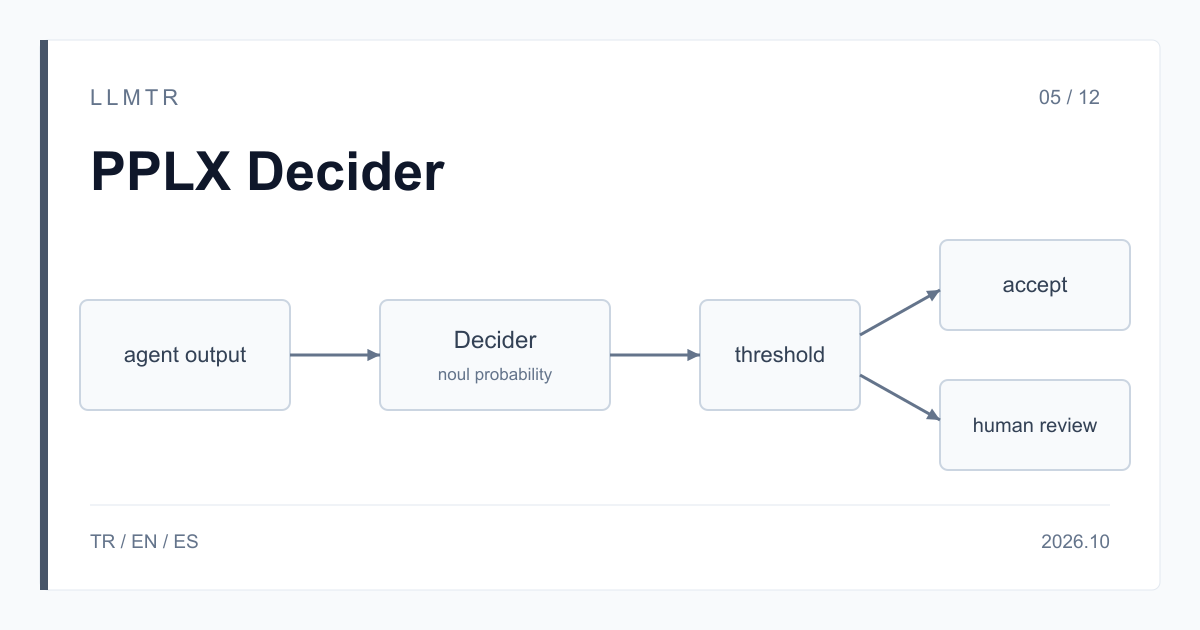
Cuando el agente termina un turno, llama a la función verify de abajo antes de que la respuesta llegue al usuario o de ejecutar una acción. Si todas las comprobaciones superan su umbral, la respuesta se envía; si una falla, pasa a revisión humana. El estado es un objeto JSON con los campos user_message, tool_result y agent_answer, y los nombres los eliges tú.
Cada comprobación es una pregunta aparte y las preguntas se evalúan por separado: el resultado de una nunca es contexto de otra. Las claves no llegan al modelo, así que la comprobación completa se escribe como una frase entera en instructions.
Función en Python que revisa la respuesta de un agente con tres preguntas noul y devuelve send o human_review.
import os

import requests

CHECKS = {
    "grounded": {
        "type": "noul",
        "instructions": "Is every figure and claim in the agent answer supported by the tool result?",
    },
    "answers_question": {
        "type": "noul",
        "instructions": "Does the agent answer address what the user asked?",
    },
    "promises_action": {
        "type": "noul",
        "instructions": "Does the agent answer promise an action such as a refund, a call or a delivery date?",
    },
}
# Thresholds live next to the questions they apply to.
THRESHOLDS = {"grounded": 0.9, "answers_question": 0.9, "promises_action": 0.2}


def verify(user_message, tool_result, agent_answer):
    response = requests.post(
        "https://llmtr.com/v1/systemone",
        headers={"Authorization": "Bearer " + os.environ["LLMTR_API_KEY"]},
        json={
            "model": "perplexity/pplx-decider-v1.1-27b",
            "state": {
                "user_message": user_message,
                "tool_result": tool_result,
                "agent_answer": agent_answer,
            },
            "questions": CHECKS,
        },
        timeout=90,
    )
    response.raise_for_status()
    answers = response.json()["answers"]
    passed = (
        answers["grounded"]["noul"] >= THRESHOLDS["grounded"]
        and answers["answers_question"]["noul"] >= THRESHOLDS["answers_question"]
        and answers["promises_action"]["noul"] <= THRESHOLDS["promises_action"]
    )
    return "send" if passed else "human_review"
Convertir la lista de control en preguntas noul
Cada comprobación debe preguntar por una sola condición. En lugar de algo amplio como «¿la respuesta es buena?», escribe condiciones verificables: ¿cada cifra de la respuesta aparece en el resultado de la herramienta?, ¿la respuesta atiende lo que preguntó el usuario?, ¿el agente promete una acción que no puede hacer? Puedes precisar el límite describiendo los extremos true y false en criteria.
Para valorar un nivel, como el tono de la respuesta, usa score en lugar de noul; un noul de 0,5 significa incertidumbre, no calidad media. Si quieres que el modelo elija el siguiente paso, define opciones como send, revise y escalate con choice; la respuesta choice trae además un valor confidence.
| Clave | Pregunta | Tipo | Umbral de ejemplo |
|---|---|---|---|
| grounded | ¿Cada cifra y afirmación de la respuesta está en el resultado de la herramienta? | noul | 0,9 o más |
| answers_question | ¿La respuesta atiende lo que preguntó el usuario? | noul | 0,9 o más |
| promises_action | ¿La respuesta promete una acción como un reembolso, una llamada o una fecha de entrega? | noul | 0,2 o menos |
Dónde poner el umbral y cuándo pasar el caso a una persona
Las probabilidades son una estimación del modelo, no una garantía. Fija los umbrales con ejemplos reales: toma respuestas pasadas del agente que sabes correctas o incorrectas, mira qué probabilidades les da Decider y elige desde qué punto enviar de forma automática. Los valores cercanos a 0,5 indican que el modelo está indeciso; no dejes ese rango a una decisión automática.
No descartes en silencio una respuesta por debajo del umbral: pásala a una persona o haz que el agente la reescriba y vuelve a revisarla. Guarda umbrales y preguntas en un solo lugar del código, como CHECKS y THRESHOLDS en el ejemplo. Así quien revise ve por qué se envió o se detuvo una respuesta.
Coste y latencia: cada revisión cuesta sus tokens de entrada
La entrada cuesta 0,02 $ por 1M de tokens y la salida no tiene precio. El estado se cuenta de nuevo en cada pregunta: tres comprobaciones sobre un estado de 3.000 tokens suman unos 9.000 tokens de entrada. Una revisión cuesta así unos 0,00018 $, y 10.000 revisiones unos 1,80 $, sin contar el texto de las preguntas. Limita las comprobaciones a las que de verdad cambian la decisión; una solicitud admite como máximo 128 preguntas.
El tiempo de respuesta crece con la entrada. Con resultados de herramienta largos, pon el timeout del cliente en 90 segundos como mínimo, como timeout=90 en el ejemplo. Cada pregunta junto con el estado debe quedar por debajo de 262.144 tokens; si lo supera, la solicitud devuelve 502 tras cerca de un minuto. Recorta los resultados muy largos a la parte de la que depende la decisión.
Empezar en LLMTR: cuenta, clave y primera revisión
Crea una cuenta en llmtr.com, recarga crédito y genera una clave en Dashboard > API Keys; la clave sin procesar se muestra una sola vez, así que guárdala en la variable de entorno LLMTR_API_KEY. Después conecta la función verify al paso de respuesta de tu agente. Las solicitudes se descuentan del crédito prepago al precio del catálogo, y la misma clave sirve para todos los modelos del catálogo, también los de chat que usa tu agente.
Revisar la respuesta de un agente con Perplexity Decider
Convierte tu lista de control en preguntas noul, revisa la respuesta del agente con perplexity/pplx-decider-v1.1-27b en https://llmtr.com/v1/systemone y pasa a una persona lo que no supere el umbral.
- Clave. Crea una cuenta en llmtr.com, recarga crédito, genera una clave en Dashboard > API Keys y guárdala en la variable de entorno LLMTR_API_KEY.
- Lista de control. Escribe cada comprobación en instructions como una pregunta noul sobre una sola condición y elige un umbral para cada una.
- Revisión. Envía la pregunta del usuario, el resultado de la herramienta y la respuesta del agente como estado a https://llmtr.com/v1/systemone, y pasa a una persona las respuestas por debajo del umbral.
Frequently asked questions
¿Se puede usar Perplexity Decider como LLM-as-a-judge?
Sí, para comprobaciones que se pueden escribir como sí/no o como elección. Decider no genera texto, devuelve una probabilidad por comprobación y no escribe justificación. En LLMTR se llama como perplexity/pplx-decider-v1.1-27b en /v1/systemone.
¿Cuánto cuesta revisar la respuesta de un agente con Decider?
La entrada cuesta 0,02 $ por 1M de tokens. Con un estado de 3.000 tokens y tres preguntas, una revisión son unos 9.000 tokens de entrada, es decir, unos 0,00018 $. La salida no tiene precio.
¿Qué umbral debería usar?
No hay un único valor correcto; fíjalo con tus propios ejemplos. Los valores cercanos a 0,5 indican que el modelo está indeciso. Pasa a una persona las respuestas por debajo del umbral.