Comparativa de modelos · 2026-10-06
Gemini 3.1 Pro vs 3.7 Flash para programar
Compara Gemini 3.1 Pro Preview y Gemini 3.7 Flash para código: precios, contexto, razonamiento, herramientas y una regla práctica de escalado.
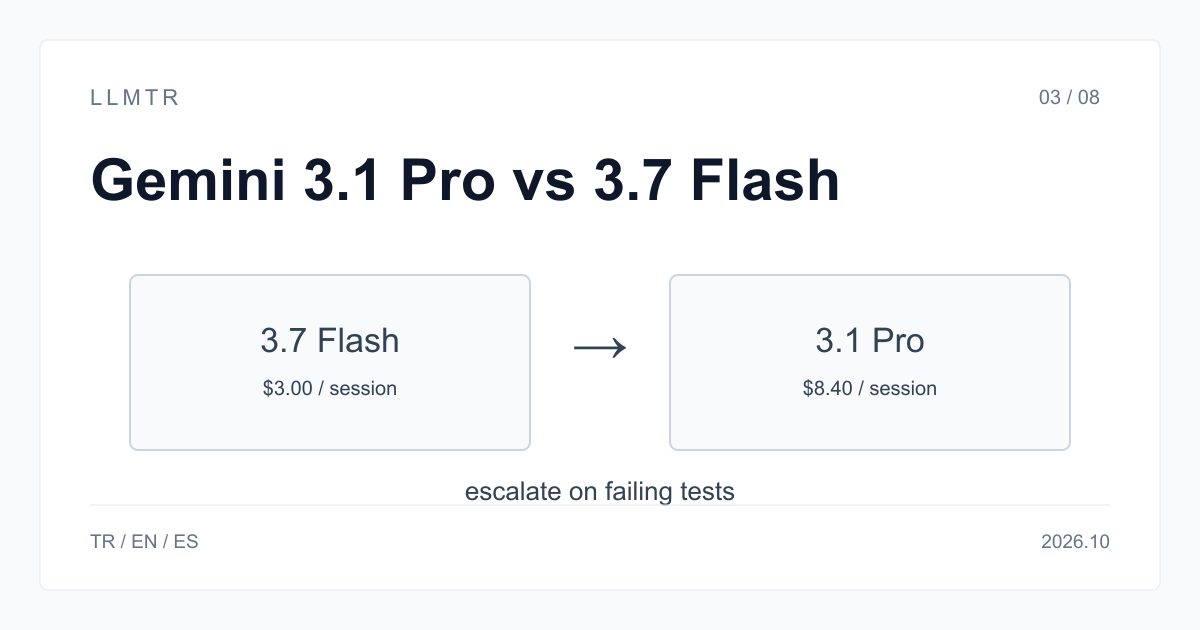
Respuesta corta: usa Flash primero y Pro al fallar
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. Compara ambos en https://llmtr.com/v1 con google/gemini-3.1-pro-preview y google/gemini-3.7-flash. La ruta POST https://llmtr.com/v1/chat/completions usa la misma clave. Para código, empieza con Flash y cambia a Pro solo si Flash falla tus pruebas.
La tabla fija contexto, salida máxima, precios y razonamiento. Google describe Pro Preview como optimizado para ingeniería de software y flujos agénticos; la página de Flash enumera ejecución de código, pero no formula una afirmación específica de programación. No hay cifras de benchmarks de código verificadas para comparar calidad.
| Campo | google/gemini-3.1-pro-preview | google/gemini-3.7-flash |
|---|---|---|
| Ventana de contexto | 1.048.576 tokens | 1.048.576 tokens |
| Salida máxima | 65.536 tokens | 65.536 tokens |
| Entrada / salida por 1M tokens | $2.00 / $12.00 (prompts de hasta 200K) | $0.75 / $3.75 (hasta 2026-12-31) |
| Por encima de 200K tokens de prompt | $4.00 / $18.00 | el mismo precio |
| Lectura de caché por 1M tokens | — | $0.075 |
| Precio desde 2027-01-01 | sin cambios | $1.50 / $7.50 |
| Control del razonamiento | — | reasoning_effort low, medium (default), high |
Gemini 3.1 Pro vs 3.7 Flash para programar
Usa Gemini 3.1 Pro Preview para las tareas que Gemini 3.7 Flash no supera en tus pruebas y Flash para las demás. En 100 pasos, Pro cuesta 8,40 $ y Flash 3,00 $ hasta 2026-12-31; Pro cuesta 2,8 veces Flash en ese caso.
Ejecuta con Flash tus pruebas que fallan o una muestra de tickets reales. Pasa a Pro solo los casos no resueltos, con los mismos prompts y contexto del repositorio. La decisión queda ligada a fallos concretos, no a una afirmación general sobre calidad de código.
Regla de enrutamiento para trabajo de código
Usa Flash por defecto en ediciones, pruebas, refactorizaciones y bucles de agente. Ejecuta tus pruebas fallidas o tickets reales y mueve a google/gemini-3.1-pro-preview solo los casos que Flash no supera, con iguales prompts y contexto del repositorio. Ambos usan POST https://llmtr.com/v1/chat/completions y la misma clave; cambia solo model. El ejemplo activa reasoning_effort high con Flash y después escala a Pro; el razonamiento se factura como salida.
La solicitud cambia solo el campo model entre Flash y Pro.
import os
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])
task = "Refactor this function to remove the N+1 query and add a unit test:\n..."

# Default: Gemini 3.7 Flash with a higher thinking level for code.
draft = client.chat.completions.create(
    model="google/gemini-3.7-flash",
    reasoning_effort="high",
    messages=[{"role": "user", "content": task}],
)

# Escalate to Gemini 3.1 Pro Preview only for tasks where Flash fails your tests.
review = client.chat.completions.create(
    model="google/gemini-3.1-pro-preview",
    messages=[{"role": "user", "content": task}],
)
print(draft.usage, review.usage)
Coste de una sesión de agente de código
En la sesión de 100 pasos, con 30.000 tokens de entrada y 2.000 de salida por paso, se consumen 3M y 0.2M tokens. Flash cuesta 3,00 $ hasta 2026-12-31 y 6,00 $ desde 2027-01-01; Pro cuesta 8,40 $, 2,8 veces Flash actualmente. Los tokens de razonamiento se cobran como salida, así que un nivel mayor aumenta esa parte de la factura.
| Identificador del modelo | Coste de entrada | Coste de salida | Total |
|---|---|---|---|
| google/gemini-3.7-flash (hasta 2026-12-31) | 3M x $0.75 = $2.25 | 0.2M x $3.75 = $0.75 | $3.00 |
| google/gemini-3.7-flash (desde 2027-01-01) | 3M x $1.50 = $4.50 | 0.2M x $7.50 = $1.50 | $6.00 |
| google/gemini-3.1-pro-preview | 3M x $2.00 = $6.00 | 0.2M x $12.00 = $2.40 | $8.40 |
Notas prácticas
Los dos modelos ofrecen 1.048.576 tokens de contexto y 65.536 tokens de salida máxima. Para prompts de más de 200K tokens, Pro sube a 4,00 $ de entrada y 18,00 $ de salida por 1M; la lectura de caché de Flash cuesta 0,075 $ por 1M durante el precio introductorio hasta 2026-12-31. Pro Preview está orientado a ingeniería de software y flujos agénticos; para herramientas personalizadas y comandos bash, usa google/gemini-3.1-pro-preview-customtools. Flash permite reasoning_effort low, medium (default) y high, admite ejecución de código y uso del ordenador.
Empezar en LLMTR: cuenta, crédito, clave y primera solicitud
Paso 1: crea una cuenta en llmtr.com y verifica tu correo. Paso 2: recarga crédito desde el Dashboard mediante el pago seguro. El margen de plataforma del 8% se añade una sola vez sobre la recarga solicitada: un crédito de 10,00 $ se cobra como 10,80 $. No se aplica a los precios de los modelos; cada llamada se descuenta al precio de catálogo del modelo.
Paso 3: crea una clave API en Dashboard > API Keys. La clave en bruto solo se muestra una vez; guárdala en una variable como LLMTR_API_KEY. Paso 4: envía la primera solicitud a https://llmtr.com/v1 con cualquier SDK compatible con OpenAI y cambia solo base_url y api_key. El Dashboard muestra uso y gasto por clave. La misma clave y el mismo saldo de crédito sirven para todo el catálogo; cambiar de modelo significa cambiar la cadena del campo model.
Configurar el acceso a Gemini con LLMTR
Crea la cuenta, añade crédito, genera una clave y realiza la primera solicitud desde un SDK compatible con OpenAI.
- Crear una cuenta. Regístrate en llmtr.com y verifica tu dirección de correo.
- Recargar crédito. Abre el Dashboard y añade crédito mediante el pago seguro. El margen de plataforma del 8% se aplica una sola vez sobre la recarga.
- Crear una clave API. Abre Dashboard > API Keys, genera una clave y guárdala en la variable de entorno LLMTR_API_KEY, porque solo se muestra una vez.
- Enviar la primera solicitud. Envía una solicitud POST a https://llmtr.com/v1/chat/completions con un SDK compatible con OpenAI. Configura base_url como https://llmtr.com/v1 y api_key con LLMTR_API_KEY.
Frequently asked questions
¿Es mejor Gemini 3.1 Pro que Gemini 3.7 Flash para programar?
Usa Flash por defecto y pasa a Pro solo cuando Flash falle en tus pruebas. En la sesión de 100 pasos, Pro cuesta 8,40 $ frente a 3,00 $ de Flash hasta 2026-12-31.
¿Cuánto cuesta Gemini 3.7 Flash después de 2026?
Desde 2027-01-01, el precio estándar es 1,50 $ por 1M tokens de entrada y 7,50 $ por 1M tokens de salida.
¿Ambos modelos tienen la misma ventana de contexto?
Sí. Ambos ofrecen 1.048.576 tokens de contexto y un máximo de 65.536 tokens de salida.