Comparativa de modelos · 2026-10-06
GPT-5.6 Luna vs GPT-5.6 Luna Pro: diferencias y precios
Compara GPT-5.6 Luna y GPT-5.6 Luna Pro en LLMTR: mismo gpt-5.6-luna, distinto modo de razonamiento y precios por token iguales desde el 2026-07-30.
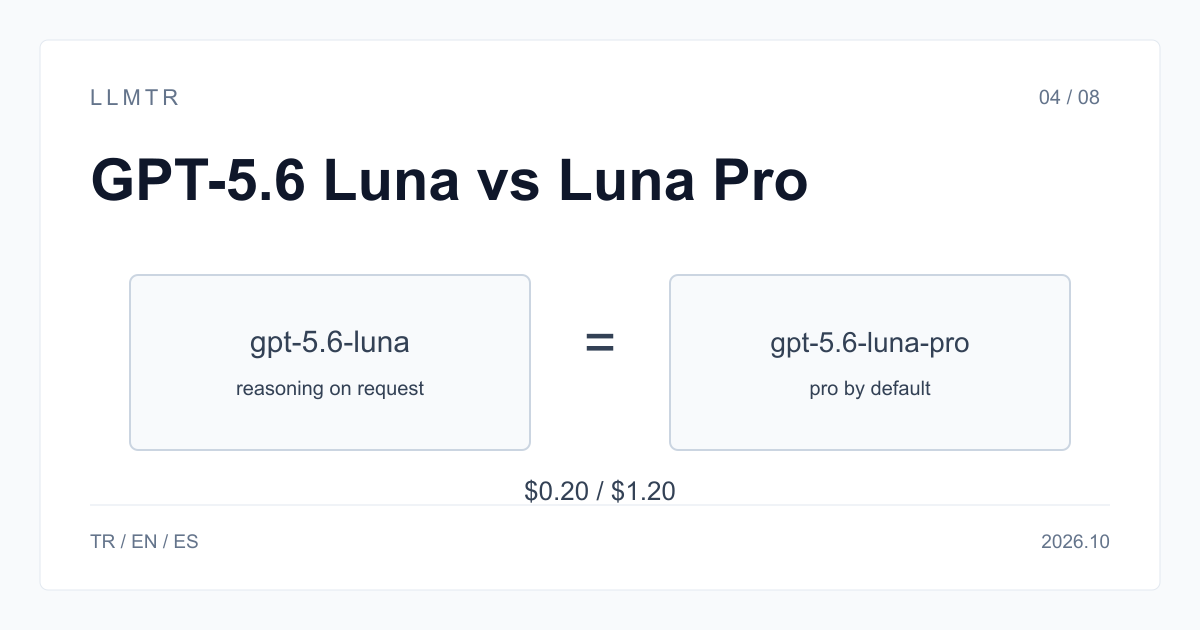
Respuesta corta: mismo modelo, distinto modo pro
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. En LLMTR, openai/gpt-5.6-luna y openai/gpt-5.6-luna-pro enrutan al mismo gpt-5.6-luna: el primero admite pro por solicitud y el segundo lo envía por defecto. Ambos se llaman en /v1/responses usando https://llmtr.com/v1.
La diferencia no está en el modelo subyacente ni en las tarifas por token, sino en el valor predeterminado del modo de razonamiento. El contexto es de 1.050.000 tokens y la salida máxima, de 128.000 tokens. Para producción, compara el uso de ambos identificadores con los mismos prompts.
| Campo | openai/gpt-5.6-luna | openai/gpt-5.6-luna-pro |
|---|---|---|
| Modelo de OpenAI subyacente | gpt-5.6-luna | gpt-5.6-luna |
| Modo de razonamiento | estándar; pro por solicitud | pro por defecto |
| Entrada / salida por 1M de tokens | $0.20 / $1.20 | $0.20 / $1.20 |
| Lectura de caché por 1M de tokens | $0.02 | $0.02 |
| Contexto / salida máxima | 1.050.000 / 128.000 | 1.050.000 / 128.000 |
| Esfuerzo de razonamiento | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Punto de conexión | /v1/responses | /v1/responses |
GPT-5.6 Luna vs GPT-5.6 Luna Pro: ¿en qué se diferencian?
La diferencia es el modo de razonamiento predeterminado, no el modelo: ambos identificadores enrutan a gpt-5.6-luna. Desde la comprobación del 2026-10-06, Luna ofrece el modo estándar y acepta pro por solicitud, mientras Luna Pro envía pro por defecto en las solicitudes de LLMTR.
La página de OpenAI para gpt-5.6-luna existe; la página de gpt-5.6-luna-pro devolvió 404 el 2026-10-06. Por tanto, el sufijo pro identifica una configuración de LLMTR sobre el mismo modelo. Para una llamada, puedes cambiar únicamente el identificador y conservar el punto de conexión, la clave y los límites.
Cómo llamar a Luna y Luna Pro
Los dos identificadores se llaman con POST https://llmtr.com/v1/responses y la misma clave. En el ejemplo de Python, la configuración base_url apunta a https://llmtr.com/v1 y la clave se toma de LLMTR_API_KEY; Luna fija effort low y Luna Pro no necesita un campo adicional en cada llamada.
Luna también puede recibir el modo pro por solicitud, pero no es su valor predeterminado. El código imprime fast.usage y careful.usage para que puedas contrastar el consumo. Compara output_tokens con los mismos prompts antes de decidir qué identificador corresponde a cada tarea.
Ejemplo de Python para llamar a ambos identificadores mediante POST /v1/responses con la misma clave.
import os
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])

# GPT-5.6 Luna: standard reasoning mode, effort chosen per request.
fast = client.responses.create(
    model="openai/gpt-5.6-luna",
    reasoning={"effort": "low"},
    input="Classify this ticket as billing, bug or feature request: ...",
)

# GPT-5.6 Luna Pro: same OpenAI model and price, pro reasoning mode sent by default.
careful = client.responses.create(
    model="openai/gpt-5.6-luna-pro",
    input="Review this contract clause and list the risks: ...",
)
print(fast.usage, careful.usage)
Qué determina el coste
Ambos identificadores cuestan 0,20 $ por 1M de tokens de entrada, 1,20 $ por 1M de tokens de salida y 0,02 $ por 1M de tokens de lectura de caché desde el 2026-07-30. Como las tarifas son idénticas, la diferencia de coste por solicitud depende de cuántos tokens de salida produce, incluidos los de razonamiento, que se facturan como salida.
Para evaluar la diferencia, usa los mismos prompts y compara usage.output_tokens; no cambies a la vez el prompt y el identificador. Antes del 2026-07-30, el precio del catálogo era 1,00 $ de entrada, 6,00 $ de salida y 0,10 $ de caché por cada 1M de tokens.
Qué identificador elegir para cada tarea
Usa openai/gpt-5.6-luna para clasificación de alto volumen, enrutamiento, resumen y asistentes. Su modo estándar cubre el tráfico principal y admite flujos controlados por coste; también puedes seleccionar pro por solicitud para una entrada concreta dentro de la misma integración sin cambiar de modelo.
Reserva openai/gpt-5.6-luna-pro para una parte seleccionada de solicitudes que necesite un aumento de calidad manteniendo la lista de precios de Luna. Enruta por tarea: deja openai/gpt-5.6-luna para el volumen general y cambia a openai/gpt-5.6-luna-pro solo cuando quieras pro por defecto en la integración.
Empezar en LLMTR: cuenta, crédito, clave y primera solicitud
Paso 1: crea una cuenta en llmtr.com y verifica tu correo electrónico. Paso 2: recarga crédito desde el Dashboard mediante el pago seguro. El margen de plataforma del 8% se añade una sola vez sobre la cantidad solicitada: una recarga de 10,00 $ se cobra como 10,80 $. El margen no se suma a los precios de los modelos; cada llamada se descuenta al precio de catálogo.
Paso 3: crea una clave en Dashboard > API Keys. La clave sin procesar se muestra una sola vez; guárdala como la variable de entorno LLMTR_API_KEY. Paso 4: envía la primera solicitud a https://llmtr.com/v1 con cualquier SDK compatible con OpenAI, cambiando solo base_url y api_key. El Dashboard muestra el uso y el gasto por clave; la misma clave y el mismo saldo sirven para todo el catálogo. Cambia únicamente la cadena model para cambiar de modelo.
Configurar GPT-5.6 Luna y Luna Pro en LLMTR
Crea una cuenta, recarga crédito, genera una clave y realiza una llamada a la Responses API con el identificador que necesites.
- Crear cuenta. Crea una cuenta en llmtr.com y verifica tu correo electrónico.
- Recargar crédito. Entra en el Dashboard y recarga crédito mediante el pago seguro. El margen de plataforma del 8% se añade una sola vez: una recarga de 10,00 $ se cobra como 10,80 $. Cada llamada se descuenta al precio de catálogo del modelo.
- Crear clave de API. En Dashboard > API Keys, crea una clave. La clave sin procesar se muestra una sola vez; guárdala como la variable de entorno LLMTR_API_KEY.
- Enviar la primera solicitud. Configura base_url como https://llmtr.com/v1 y llama mediante POST https://llmtr.com/v1/responses con cualquier SDK compatible con OpenAI. Usa la misma clave y el mismo saldo; cambia la cadena model para seleccionar Luna o Luna Pro.
Frequently asked questions
¿GPT-5.6 Luna Pro es un modelo distinto de GPT-5.6 Luna?
No. En LLMTR, ambos enrutan a gpt-5.6-luna; openai/gpt-5.6-luna-pro solo añade reasoning.mode = "pro" por defecto. La página de gpt-5.6-luna-pro devolvió 404 el 2026-10-06.
¿GPT-5.6 Luna Pro cuesta más que GPT-5.6 Luna?
No por token: ambos cuestan 0,20 $ por 1M de tokens de entrada, 1,20 $ por 1M de salida y 0,02 $ por 1M de lectura de caché. El coste cambia solo por los tokens de salida, incluidos los de razonamiento.
¿Cuál es la ventana de contexto de GPT-5.6 Luna?
Tiene 1.050.000 tokens de contexto y admite hasta 128.000 tokens de salida máxima.