Guías de integración · 2026-10-01
Llamadas a herramientas con MiniMax M3.1 Flash Preview: un bucle de agente con el SDK de OpenAI
Gracias a nuestra colaboración con MiniMax, MiniMax M3.1 Flash Preview es gratuito hasta el 6 de octubre de 2026. Llamadas a herramientas con él: definición de herramientas, la respuesta tool_calls, el resultado de la herramienta y un bucle de agente en Python con límite de pasos.
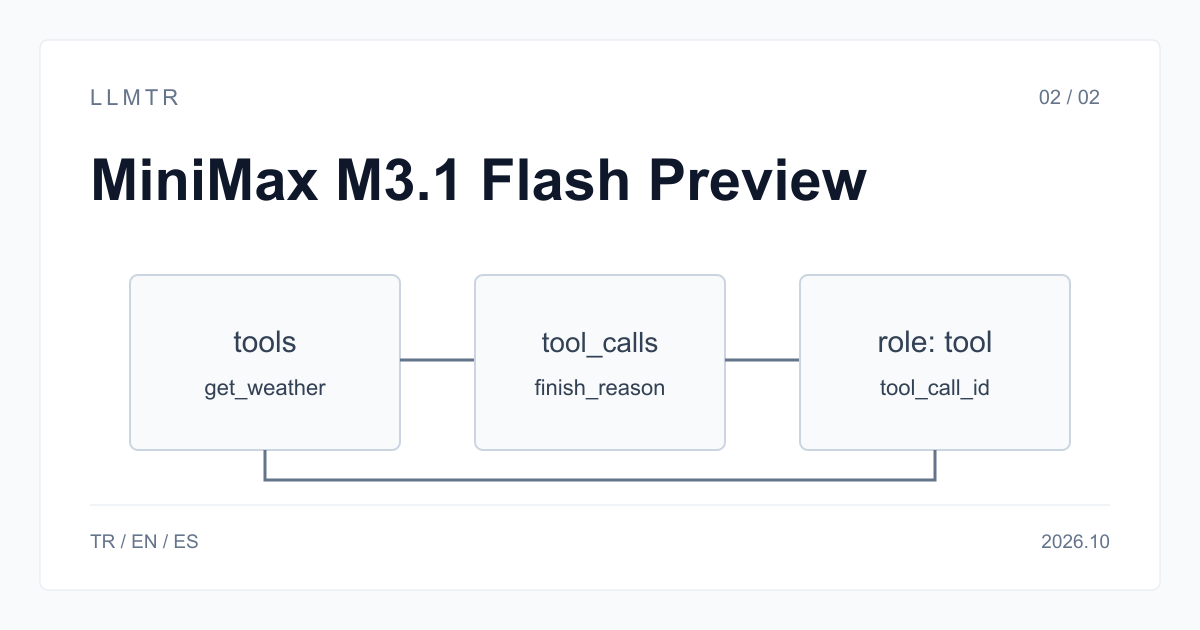
Respuesta corta: el bucle tiene cuatro pasos
MiniMax M3.1 Flash Preview admite llamadas a herramientas (tool calling) en LLMTR a través del endpoint /v1/chat/completions compatible con OpenAI. LLMTR es una pasarela de API de IA que conecta los SDK que hablan el formato de OpenAI con muchos modelos usando una sola clave de API; la URL base es https://llmtr.com/v1 y el identificador del modelo es minimax/minimax-m3.1-flash-preview. Gracias a nuestra colaboración con MiniMax, el modelo es gratuito hasta el 6 de octubre de 2026 a las 23:59 (hora de Turquía).
El bucle tiene cuatro pasos. Define tus herramientas en el campo tools. Si el modelo quiere llamar a una herramienta, la respuesta trae finish_reason tool_calls y una lista message.tool_calls. Ejecuta la herramienta en tu propio código y devuelve el resultado con role tool y el mismo tool_call_id. Repite hasta que el modelo dé la respuesta final con finish_reason stop. Este modelo no se ofrece en /v1/responses; construye el bucle sobre Chat Completions.
Ejemplo en Python: un bucle con límite de pasos
El ejemplo se conecta a LLMTR con el ajuste base_url del SDK de OpenAI para Python. No escribas la clave en el código; léela de la variable de entorno LLMTR_API_KEY. El bucle está limitado a ocho turnos: si una herramienta devuelve algo inesperado, el modelo puede volver a llamarla y, sin límite, el bucle no termina.
Añade cada respuesta del modelo, con sus llamadas a herramientas, al historial de mensajes tal como llega; los mensajes con role tool solo pueden ir después del mensaje del asistente que los pidió. El campo arguments es un texto JSON; analízalo con json.loads y valida los valores con tus propias reglas antes de ejecutar la herramienta.
Bucle de agente con límite de pasos sobre POST /v1/chat/completions
import json
import os

from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])
MODEL = "minimax/minimax-m3.1-flash-preview"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Devuelve la temperatura actual en grados Celsius de una ciudad",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]


def get_weather(city: str) -> dict:
    return {"city": city, "celsius": 17}  # llama aquí a tu servicio real


messages = [{"role": "user", "content": "¿Qué temperatura hace ahora en Ankara?"}]

for step in range(8):  # límite de pasos: el bucle no debe ser infinito
    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        tools=tools,
        reasoning_effort="low",
        max_tokens=4000,
    )
    message = response.choices[0].message
    messages.append(message.model_dump(exclude_none=True))
    if not message.tool_calls:
        print(message.content)
        break
    for call in message.tool_calls:
        args = json.loads(call.function.arguments)
        result = get_weather(**args)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})
El flujo que medimos
El 1 de octubre de 2026 ejecutamos a través de LLMTR un bucle de dos turnos con una herramienta del tiempo (reasoning_effort low, max_tokens 4000). El ejemplo de Python de arriba se ejecutó tal cual dos veces ese mismo día; en ambas empezó con una llamada a la herramienta y terminó con la temperatura correcta. En el primer turno el campo content llegó vacío y los argumentos eran un texto JSON válido. También probamos el mismo flujo en el endpoint /v1/messages con formato Anthropic; allí la llamada llegó como bloque tool_use y el resultado enviado con tool_result produjo la respuesta correcta.
| Turno | Enviado | finish_reason | Recibido |
|---|---|---|---|
| 1 | Pregunta del usuario y tools | tool_calls | Llamada a get_weather, arguments {"city": "Ankara"}; content vacío |
| 2 | Mensaje del asistente y resultado con role tool | stop | Respuesta de texto con la temperatura |
Cómo aparece el razonamiento en el bucle
El modelo razona primero en cada turno. En una respuesta sin streaming el texto de razonamiento no forma parte del mensaje; si envías la solicitud con stream: true, el razonamiento llega como fragmentos delta.reasoning_content antes del texto de la respuesta. Los tokens de razonamiento no aparecen en un contador aparte; están incluidos en usage.completion_tokens.
En nuestra prueba bastó con añadir el mensaje del asistente sin el texto de razonamiento, y el segundo turno dio la respuesta correcta. Deja margen para el razonamiento en max_tokens en cada turno: si el límite es bajo, un turno puede cortarse con length antes de producir la llamada a la herramienta. Para elegir herramientas sencillas bastó reasoning_effort low; para planificación en varios pasos prueba un nivel más alto.
JSON, imágenes y límites
Junto a las llamadas a herramientas funciona el modo de objeto JSON (response_format: json_object). La salida ajustada a un esquema con json_schema no está garantizada; valida tanto la respuesta final como los argumentos de las herramientas por tu cuenta. Puedes enviar imágenes como partes image_url con el formato de OpenAI; la entrada de vídeo no figura en esta ficha. Mantén las descripciones de las herramientas breves y claras; el modelo decide con ellas qué herramienta llamar y cuándo.
La ventana de contexto es de 1.000.000 de tokens y una respuesta genera como máximo 524.288 tokens. En sesiones largas el historial se reenvía en cada turno y la entrada crece de un turno a otro. El modelo es gratuito y esto no se descuenta de tu saldo, pero acortar los resultados antiguos reduce cada solicitud.
Respuestas de error y después del 6 de octubre
402 top_up_required: tu cuenta nunca ha recargado saldo. Recarga al menos 5 $ y vuelve a intentarlo pasado un minuto; el modelo no se descuenta de tu saldo. 429: se agotó la cuota gratuita diaria o se enviaron demasiadas solicitudes en poco tiempo; no repitas el turno de inmediato, usa reintentos con espera exponencial. 503 model_unavailable: al estar en beta cerrada, el modelo puede no estar disponible temporalmente.
410 model_retired: desde el 7 de octubre de 2026 este identificador está retirado y la respuesta sugiere minimax/minimax-m3. Tu bucle no debe reintentar un 410 como un error pasajero; debe detenerse e informar. M3 admite llamadas a herramientas, pero su ficha no incluye niveles de reasoning_effort ni modo JSON; quita esos campos del cuerpo al cambiar. El cambio no es automático.
Crear un bucle de agente con llamadas a herramientas en MiniMax M3.1 Flash Preview
Pasos para un bucle de tool calling con límite de pasos usando el SDK de OpenAI para Python y el endpoint /v1/chat/completions de LLMTR.
- Define las herramientas. Añade cada herramienta a la lista tools con nombre, descripción y esquema JSON.
- Envía la solicitud. Escribe minimax/minimax-m3.1-flash-preview en el campo model y fija reasoning_effort y max_tokens.
- Ejecuta las llamadas. Si finish_reason es tool_calls, ejecuta cada llamada y añade el resultado con role tool y el mismo tool_call_id.
- Repite con un límite. Repite hasta que finish_reason sea stop, sin superar el número máximo de turnos que fijes.
Frequently asked questions
¿Admite MiniMax M3.1 Flash Preview llamadas a herramientas?
Sí. Funciona con el campo tools en /v1/chat/completions; cuando el modelo llama a una herramienta, finish_reason es tool_calls. En el endpoint /v1/messages con formato Anthropic llega como bloque tool_use.
¿Tengo que incluir el texto de razonamiento al enviar el resultado de la herramienta?
No en nuestra prueba del 1 de octubre de 2026: bastó con añadir el mensaje del asistente sin el razonamiento, y el segundo turno dio la respuesta correcta.
¿Puedo usar este modelo con /v1/responses?
No. La solicitud recibe un 400 unsupported_operation. Construye el bucle del agente sobre /v1/chat/completions.