Flujos de agentes · 2026-10-14
Agente con Qwen gratis: llamadas a herramientas con Qwen3.8 27B
Bucle de agente con Qwen3.8 27B, gratis hasta el 2 de noviembre de 2026 y con function calling en su ficha: SDK de OpenAI, max_tokens, 429, 402 y 410.
Respuesta corta: gratis hasta el 2 de noviembre de 2026, 00:00 (hora de Turquía)
Puedes llamar gratis a Qwen3.8 27B hasta el 2 de noviembre de 2026, 00:00 (hora de Turquía), y la ficha del modelo indica llamadas a herramientas, así que puedes montar un bucle de agente con esta fila y probarlo con tus herramientas. LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. El id del modelo es heabsy/qwen3.8-27b-heabsy-free y la URL base es https://llmtr.com/v1. Hasta esa fecha pagas 0,00 $ por 1M de tokens, tanto de entrada como de salida, y no se descuenta crédito.
El uso tiene un límite diario por cuenta. La ficha también indica entrada de imágenes, y la ventana de contexto es de 262.144 tokens. Esta guía monta un bucle de herramientas de dos turnos con el SDK de OpenAI para Python, repasa los ajustes que importan dentro de un agente y explica cómo debe reaccionar el bucle ante respuestas como 429, 402 y 410.
¿Cómo se crea un agente que llama herramientas con Qwen gratis?
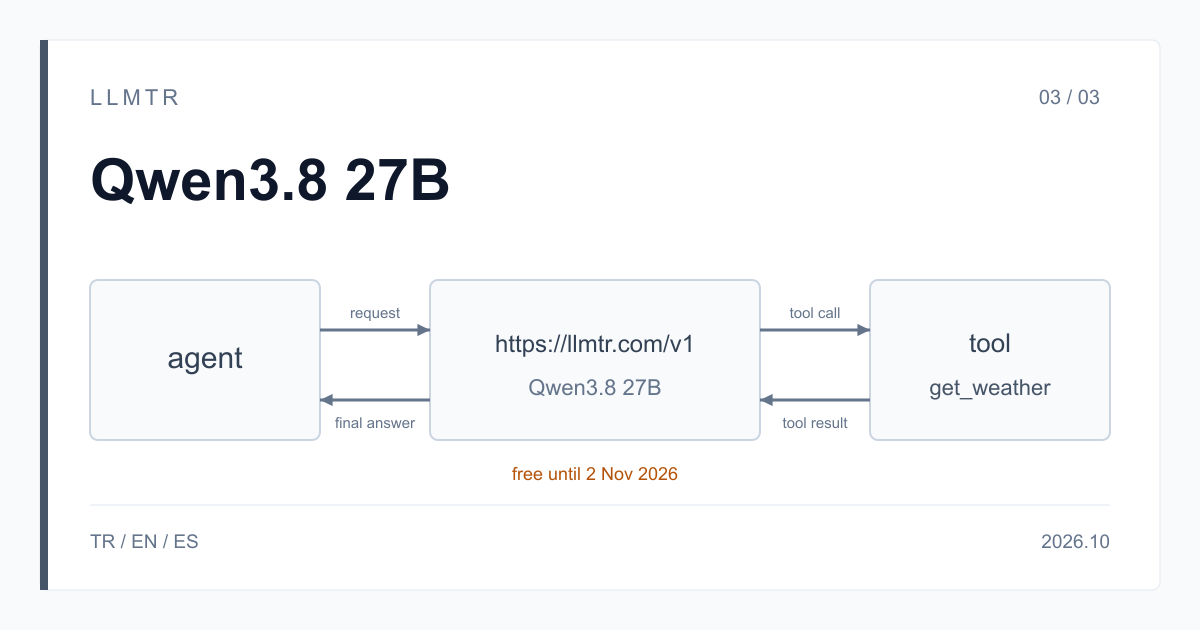
El núcleo de un agente son dos solicitudes. En la primera envías la conversación y la definición de las herramientas que el modelo puede usar. Si el modelo decide llamar a una herramienta, message.tool_calls llega con contenido; cada llamada trae el nombre de la herramienta y sus argumentos en JSON. Ejecutas la herramienta en tu propio código, añades al historial el mensaje del asistente con la llamada y un mensaje tool con el resultado, y envías la segunda solicitud. Esta vez el modelo escribe la respuesta final a partir de ese resultado.
El ejemplo tiene una sola herramienta, get_weather(city). En lugar de un servicio meteorológico real, una función local de ejemplo devuelve un resultado fijo; para conectar tu herramienta solo cambias esa función. El tool_call_id del mensaje tool debe coincidir con el id de llamada que devolvió el modelo; así sabe qué resultado corresponde a cada llamada. max_tokens vale 4096 porque los tokens de razonamiento también cuentan para ese límite.
En un cliente de OpenAI existente cambian tres cosas: base_url (https://llmtr.com/v1), api_key (tu clave de LLMTR) y el modelo (heabsy/qwen3.8-27b-heabsy-free). El SDK envía la clave por ti en el encabezado Authorization: Bearer.
Bucle de dos turnos con el SDK de OpenAI para Python: define la herramienta get_weather, responde con una función local a la llamada, si el modelo la hace, e imprime la respuesta final de la segunda solicitud.
import json
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key="llmtr-your_key")

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get the current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]


def get_weather(city):
    # Local stub: replace it with a real weather lookup.
    return {"city": city, "temperature_c": 18, "condition": "light rain"}


messages = [{"role": "user", "content": "Do I need an umbrella in Istanbul today?"}]

# Turn 1: the model decides whether to call a tool.
first = client.chat.completions.create(
    model="heabsy/qwen3.8-27b-heabsy-free",
    max_tokens=4096,
    tools=tools,
    messages=messages,
)
message = first.choices[0].message

if message.tool_calls:
    # Keep the assistant turn that asked for the tools in the history.
    messages.append({
        "role": "assistant",
        "content": message.content,
        "tool_calls": [call.model_dump() for call in message.tool_calls],
    })
    for call in message.tool_calls:
        args = json.loads(call.function.arguments)
        result = get_weather(args["city"])
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(result),
        })

    # Turn 2: the model answers from the tool result.
    second = client.chat.completions.create(
        model="heabsy/qwen3.8-27b-heabsy-free",
        max_tokens=4096,
        tools=tools,
        messages=messages,
    )
    print(second.choices[0].message.content)
else:
    print(message.content)
Ajustes que importan en un bucle de agente
La ventana de contexto es de 262.144 tokens; las salidas largas de las herramientas y el historial que crece deben caber en ella. max_tokens admite como máximo 32.768, y un valor mayor se rechaza con HTTP 400 invalid_request. El razonamiento está activado por defecto y esos tokens cuentan para max_tokens, así que deja espacio al modelo en los turnos en que elige una herramienta: 4096 o más es un buen punto de partida. Si la respuesta llega con finish_reason: "length", sube max_tokens y repite la solicitud.
reasoning_effort no es compatible con este modelo; una solicitud que lo envía se rechaza con HTTP 400 invalid_request, así que desactívalo si tu biblioteca o framework lo añade por su cuenta. stream: true se acepta, pero la respuesta llega en fragmentos cuando ya está completa; ajusta cuánto espera tu cliente el primer fragmento. El modelo se llama solo a través de /v1/chat/completions; /v1/responses no está disponible.
| Ajuste | Valor |
|---|---|
| Id del modelo | heabsy/qwen3.8-27b-heabsy-free |
| Precio (hasta el 2 de noviembre de 2026, 00:00 hora de Turquía) | 0,00 $ entrada / 0,00 $ salida por 1M de tokens |
| Ventana de contexto | 262.144 tokens |
| Límite de max_tokens | 32.768; un valor mayor recibe HTTP 400 invalid_request |
| Razonamiento | activado por defecto; cuenta para max_tokens, usa 4096 o más en turnos con herramientas |
| reasoning_effort | no compatible; HTTP 400 invalid_request |
| Llamadas a herramientas | indicadas en la ficha del modelo |
| Entrada de imágenes | indicada en la ficha del modelo |
| Streaming (stream: true) | se acepta; la respuesta llega en fragmentos cuando ya está completa |
| Endpoint | /v1/chat/completions; /v1/responses no disponible |
Cómo hacer más robusto el bucle
No supongas cuántas llamadas a herramientas trae un turno. tool_calls puede venir vacío, con una llamada o con varias; tu código debe manejar los tres casos y añadir un mensaje tool por cada llamada. Si viene vacío, la respuesta del modelo es la final. Analiza los argumentos como JSON y revisa que estén los campos que esperas antes de ejecutar nada; si no se pueden analizar, puedes devolver el error al modelo como mensaje tool en lugar de ejecutar la herramienta.
Limita el número de turnos. Mientras el modelo siga llamando herramientas, el bucle continúa; detenlo, por ejemplo, tras cinco o diez turnos y devuelve lo que tengas. El límite evita un bucle sin fin e impide que una sola tarea consuma el uso diario.
HTTP 429 significa que se alcanzó uno de los límites de uso gratuito; ese límite puede ser diario o por minuto, y la respuesta trae un encabezado Retry-After. El límite se libera por sí mismo, así que espera el tiempo indicado y reintenta. En una cuenta que aún no ha recargado saldo, una solicitud puede devolver HTTP 402 tras cierto uso, con details.reason igual a account_verification_required. La protección automática de uso pide verificar la cuenta una vez: recarga saldo una vez desde Dashboard > Billing y reintenta al cabo de un minuto; el modelo no se descuenta de tu saldo. HTTP 410 model_retired es definitivo: reintentar no sirve, así que detén el bucle y cambia la cadena del modelo.
Uso desde frameworks de agentes
Cualquier framework que acepte una base_url compatible con OpenAI, una api_key y una cadena de modelo se conecta igual: https://llmtr.com/v1 como base_url, tu clave de LLMTR como api_key y heabsy/qwen3.8-27b-heabsy-free como modelo. Por ejemplo, el cliente de chat compatible con OpenAI de un framework recibe estos tres valores; las herramientas y el bucle usan el mecanismo propio del framework, y las solicitudes van a /v1/chat/completions.
Si el framework envía reasoning_effort, desactívalo; si un cliente usa la Responses API, cámbialo al modo Chat Completions. Antes de pasar a producción, pruébalo con tus herramientas: las llamadas a herramientas son una función que indica la ficha del modelo, así que ejecuta un escenario completo con tus propios esquemas y prompts y revisa lo que devuelve.
Antes de empezar y después del 2 de noviembre
Los modelos de Heabsy no se pueden llamar hasta que tu cuenta otorgue el consentimiento de transferencia de datos para Heabsy; sin él, cada solicitud devuelve HTTP 403 provider_consent_required. Lo otorgas en la tarjeta Data-transfer consents de Settings; el consentimiento es de la cuenta y vale para todas sus claves API. Según Heabsy, el modelo funciona en centros de datos de la UE/EEE, y los prompts y las respuestas no se almacenan ni se usan para entrenamiento.
El periodo gratuito termina el 2 de noviembre de 2026, 00:00 (hora de Turquía), es decir, Europe/Istanbul, UTC+3. Después, las solicitudes a heabsy/qwen3.8-27b-heabsy-free devuelven HTTP 410 model_retired, y el error nombra el id de pago heabsy/qwen3.8-27b-heabsy. A tu agente le basta con cambiar la cadena del modelo a ese id; las herramientas y el bucle no cambian. El id de pago se factura con crédito prepago por 1M de tokens: 0,40 $ de entrada, 0,05 $ de entrada en caché y 3,00 $ de salida.
Crear un agente que llama herramientas con Qwen3.8 27B gratis
Otorga el consentimiento de Heabsy, crea una clave API, define tus herramientas y ejecuta el bucle de dos turnos con heabsy/qwen3.8-27b-heabsy-free antes del 2 de noviembre de 2026, 00:00 (hora de Turquía).
- Consentimiento y clave. En llmtr.com, otorga el consentimiento de transferencia de datos de Heabsy en Settings, crea una clave en Dashboard > API Keys y guárdala en la variable de entorno LLMTR_API_KEY.
- Define las herramientas. Escribe cada herramienta como una definición de función de OpenAI con nombre, descripción y parámetros en un esquema JSON, e impleméntala como una función en tu propio código.
- Ejecuta el bucle. Envía la primera solicitud con tools; si llegan tool_calls, ejecuta la herramienta, añade el resultado como mensaje tool con su tool_call_id y obtén la respuesta final con la segunda solicitud. Ante un 429, espera lo que indica Retry-After; ante un 410, detente.
Frequently asked questions
¿Ejecutar un agente con Qwen3.8 27B es realmente gratis?
Sí. heabsy/qwen3.8-27b-heabsy-free cuesta 0,00 $ por 1M de tokens de entrada y de salida hasta el 2 de noviembre de 2026, 00:00 (hora de Turquía), y no descuenta crédito. El uso tiene un límite diario por cuenta; al alcanzarlo, la API devuelve HTTP 429 con un encabezado Retry-After.
¿El Qwen gratuito admite llamadas a herramientas?
La ficha del modelo indica function calling. Envías el campo tools en formato OpenAI y el modelo devuelve sus llamadas en message.tool_calls. Antes de pasar a producción, pruébalo con tus herramientas.
¿Qué pasa con mi agente después del 2 de noviembre de 2026?
Las solicitudes devuelven HTTP 410 model_retired, y el error nombra el id de pago heabsy/qwen3.8-27b-heabsy. Al cambiar la cadena del modelo, el mismo agente sigue funcionando a 0,40 $ de entrada y 3,00 $ de salida por 1M de tokens.