Entegrasyon rehberleri · 2026-10-12
Alice AI LLM Flash'ta istem önbelleği: cached_tokens ve maliyet
yandex/alice-ai-llm-flash'ta tekrarlanan istem başı önbellekten okunabilir ve girdi fiyatının dörtte biriyle faturalanır. İstemi kurmak ve cached_tokens'ı okumak.
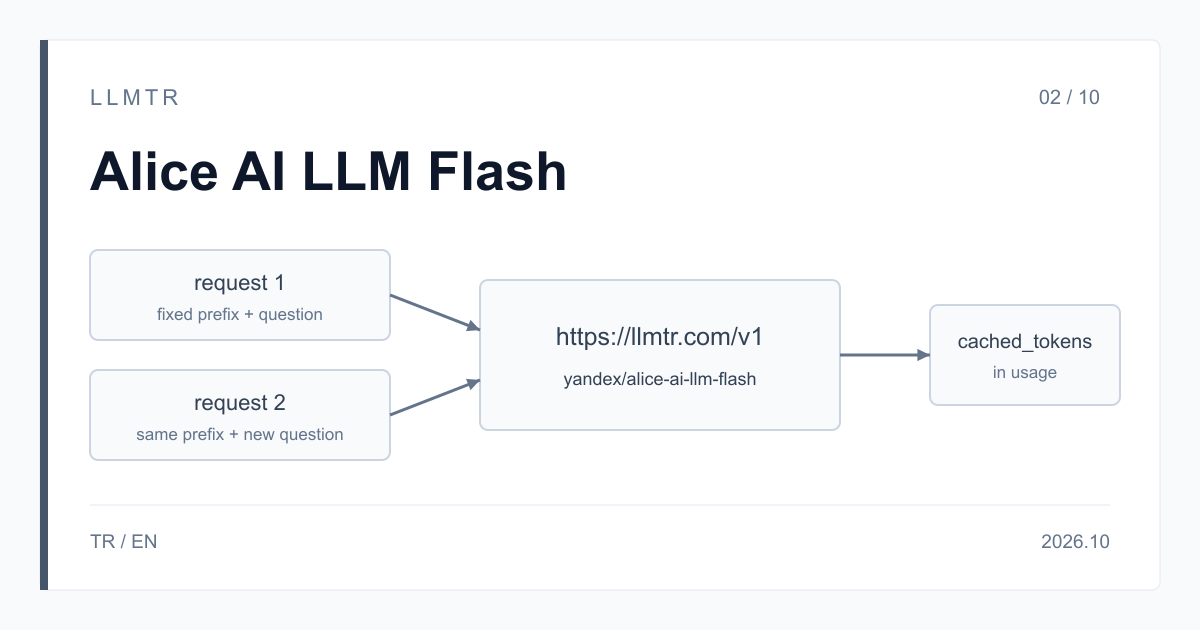
Kısa yanıt: tekrarlanan istem başı dörtte bir fiyatla faturalanır
LLMTR (llmtr.com), Türkiye'de ve global sağlayıcılarda barındırılan dil modellerine tek, OpenAI uyumlu API'den erişim veren bir gateway'dir. Alice AI LLM Flash'ı yandex/alice-ai-llm-flash kimliğiyle, https://llmtr.com/v1 adresindeki /v1/chat/completions uç noktası üzerinden çağırırsınız. Bu modelde, önceki isteklerle aynı başlayan bir istemin tekrarlanan başı önbellekten okunabilir. Önbellekten okunan token'lar 1 milyon token başına 0,204918 $ ile, yani 0,819672 $ olan girdi fiyatının dörtte biriyle faturalanır.
Önbellek isabeti olduğunda yanıtın usage.prompt_tokens_details.cached_tokens alanı önbellekten okunan token sayısını taşır; bu token'lar prompt_tokens toplamının içindedir. İsabet garanti değildir. Sizin kontrol ettiğiniz şey istemin düzenidir: sabit kısım başta ve bayt bayt aynı, değişen içerik sonda.
Alice AI LLM Flash'ta istem önbelleği maliyeti nasıl düşürür?
Bir sohbet isteğinin girdisi iki parçadan oluşur. İstem başı her istekte aynı kalan kısımdır: sistem istemi, sabit talimatlar, örnekler, bir politika belgesi. Değişen kısım ise kullanıcının sorusu ya da o isteğe özel veridir. Aynı başla gelen sonraki bir istekte bu baş önbellekten okunabilir; okunan token'lar 0,204918 $, girdinin geri kalanı 0,819672 $, çıktı 1,639344 $ fiyatından faturalanır.
Kazanç, isteğin ne kadarının önbellekten okunduğuna bağlıdır: uzun ve sabit bir baş taşıyan istekte fark büyüktür, kısa bir istemde küçüktür. Bağlam penceresi 65.536 token'dır; sabit baş ile değişen kısım birlikte bu pencereye sığmalıdır.
Katalogdaki Yandex modelleri arasında bu indirim yalnızca Alice AI LLM Flash'ta vardır; Alice AI LLM, YandexGPT 5.1 Pro, YandexGPT 5 Pro ve YandexGPT 5 Lite'ta önbellek indirimi yoktur.
| Kalem | Fiyat (1M token) | Hangi token'lara uygulanır |
|---|---|---|
| Girdi | 0,819672 $ | Önbellekten okunmayan istem token'ları |
| Önbellekten okunan girdi | 0,204918 $ | usage.prompt_tokens_details.cached_tokens içindeki token'lar |
| Çıktı | 1,639344 $ | Yanıtın completion_tokens değeri |
İstemi önbellek isabetine göre kurmak
Önbellek tekrarlanan istem başına uygulanır; bu yüzden sıra önemlidir. Her istekte aynı kalan her şeyi başa, değişen her şeyi sona koyun ve baştaki metni bayt bayt aynı tutun.
Çok turlu bir sohbette önceki mesajları değiştirmeden ve aynı sırayla geri gönderin, yeni mesajı sona ekleyin; böylece önceki turlar da tekrarlanan başın parçası olur.
- Sistem istemini kodda tek bir sabitten üretin ve her istekte aynı metni gönderin.
- Tarih, saat, kullanıcı adı ya da istek numarası gibi değişen değerleri sistem istemine gömmeyin; bunları kullanıcı mesajına taşıyın.
- Sabit belgeleri ve örnekleri sistem isteminin hemen arkasına, her seferinde aynı sırayla koyun.
- Boşluk, satır sonu ya da noktalama farkı da metni değiştirir; şablonu her istekte yeniden biçimlendirmeyin.
- Kullanıcının sorusunu ve isteğe özel veriyi en sona koyun.
cached_tokens değerini Python ile okumak
Aşağıdaki örnek OpenAI Python SDK'sıyla aynı uzun sistem istemini iki ayrı soruyla gönderir ve her yanıtın usage değerlerini yazdırır. Sistem istemi dosyadan bir kez okunur ve iki istekte de aynı metin kullanılır; değişen kısım olan soru en sondadır.
İsabet olmayan bir yanıtta alan gelmeyebilir; kod bu yüzden değeri getattr ile okur ve yokluğu 0 sayar. İkinci istekte istem başı önbellekten okunduysa cached_tokens sıfırdan büyüktür ve prompt_tokens içinde yer alır, ona eklenmez. İsabet garanti olmadığı için ikinci istekte de 0 görebilirsiniz; bu bir hata değildir, o istek tam girdi fiyatından faturalanır.
Aynı uzun sistem istemini iki kez gönderen ve her yanıtta usage.prompt_tokens_details.cached_tokens değerini yazdıran OpenAI Python SDK örneği.
import os
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])

# Fixed part: the same text, byte for byte, at the start of every request.
with open("store_policy.txt", encoding="utf-8") as f:
    SYSTEM_PROMPT = "Answer customer questions using only this policy. " + f.read()


def ask(question: str) -> str:
    response = client.chat.completions.create(
        model="yandex/alice-ai-llm-flash",
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": question},  # varying part goes last
        ],
        max_tokens=500,
    )
    usage = response.usage
    details = getattr(usage, "prompt_tokens_details", None)
    cached = getattr(details, "cached_tokens", None) or 0
    print("prompt_tokens:", usage.prompt_tokens,
          "cached_tokens:", cached,
          "completion_tokens:", usage.completion_tokens)
    return response.choices[0].message.content


ask("Can I return an opened item?")
ask("How long does a refund take?")
Maliyet örneği: 10.000 token'lık istemin 8.000 token'ı önbellekten
10.000 token'lık bir istemin 8.000 token'ı önbellekten okunsun ve yanıt 500 token olsun: (2.000 x 0,819672 + 8.000 x 0,204918 + 500 x 1,639344) / 1.000.000 = 0,004098 $. Aynı tur önbellek isabeti olmadan (10.000 x 0,819672 + 500 x 1,639344) / 1.000.000 = 0,009016 $ tutar.
Böyle 1.000 tur, önbellek isabetiyle 4,09836 $, isabetsiz 9,016392 $ eder; aradaki fark 4,918032 $.
LLMTR'deki 1M token fiyatları Yandex'in yayımladığı USD liste fiyatlarıyla aynıdır; Yandex fiyatı 1.000 token başına verir, katalog aynı fiyatı 1M token başına yazar (2026-10-12'de kontrol edildi). Bu modelin fiyatına marj eklenmez; LLMTR'nin %8 platform payı yalnızca kredi yüklerken alınır.
| Durum | Önbellekten okunmayan girdi | Önbellekten okunan girdi | Çıktı | Tek tur | 1.000 tur |
|---|---|---|---|---|---|
| Önbellek isabeti | 2.000 token | 8.000 token | 500 token | 0,004098 $ | 4,09836 $ |
| İsabet yok | 10.000 token | 0 token | 500 token | 0,009016 $ | 9,016392 $ |
Sınırlar ve LLMTR'de başlamak
Alice AI LLM Flash yalnızca metin kabul eder; görsel içeren istek 400 unsupported_input ile reddedilir ve ücretlendirilmez. reasoning_effort gönderilen istek 400 invalid_request döndürür. finish_reason değeri length ise yanıt kesilmiştir; max_tokens değerini artırıp yeniden deneyin. Akışta (stream: true) usage, stream_options.include_usage gönderildiğinde yanıtın sonunda gelir.
Başlamak için llmtr.com'da hesap açın ve ön ödemeli kredi yükleyin, Dashboard > API Anahtarları altında bir anahtar oluşturun ve SDK'da base_url olarak https://llmtr.com/v1 kullanın. Ham anahtar yalnızca bir kez gösterilir; LLMTR_API_KEY gibi bir ortam değişkeninde saklayın. Aynı anahtar katalogdaki her modelde çalışır.
Alice AI LLM Flash'ı LLMTR'de istem önbelleğiyle kullanmaya başlamak
Hesap açın, anahtar oluşturun ve yandex/alice-ai-llm-flash'a sabit sistem istemi başta olacak şekilde ilk isteği gönderin.
- Hesap ve kredi. llmtr.com'da hesap açın ve ön ödemeli kredi yükleyin.
- API anahtarı. Dashboard > API Anahtarları altında bir anahtar oluşturun. Ham anahtar bir kez gösterilir; LLMTR_API_KEY ortam değişkeninde saklayın.
- İlk istek. SDK'da base_url olarak https://llmtr.com/v1, model olarak yandex/alice-ai-llm-flash verin ve sabit sistem istemini başa koyarak ilk isteği gönderin.
Sık sorulan sorular
Alice AI LLM Flash'ta önbellek isabeti garanti mi?
Hayır. Aynı istem başı tekrar gönderildiğinde önbellekten okunabilir, ama bu garanti değildir. İsabet olmayan istekte girdinin tamamı 0,819672 $ fiyatından faturalanır.
Önbellekten okunan token'ları nerede görürüm?
Yanıtın usage.prompt_tokens_details.cached_tokens alanında. Bu token'lar prompt_tokens toplamının içindedir; önbellekten okunan kısım 0,204918 $, girdinin geri kalanı 0,819672 $ fiyatından faturalanır.
Diğer Yandex modellerinde önbellek indirimi var mı?
Hayır. LLMTR kataloğundaki Yandex modelleri arasında önbellek indirimi yalnızca Alice AI LLM Flash'ta vardır. Alice AI LLM, YandexGPT 5.1 Pro, YandexGPT 5 Pro ve YandexGPT 5 Lite'ta yoktur.