Entegrasyon rehberleri · 2026-10-01
MiniMax M3.1 Flash Preview ile araç çağrısı: OpenAI SDK'sıyla ajan döngüsü
MiniMax ile iş birliğimiz kapsamında 6 Ekim 2026'ya kadar ücretsiz olan MiniMax M3.1 Flash Preview ile tool calling: tools tanımı, tool_calls yanıtı, araç sonucu ve adım sınırlı Python ajan döngüsü.
Kısa yanıt: döngü dört adım
MiniMax M3.1 Flash Preview, LLMTR'de OpenAI uyumlu /v1/chat/completions ucundan araç çağrısını (tool calling) destekler. LLMTR, OpenAI biçimini konuşan SDK'ları tek bir API anahtarıyla birçok modele bağlayan bir yapay zeka API ağ geçididir; temel adres https://llmtr.com/v1, model kimliği minimax/minimax-m3.1-flash-preview. MiniMax ile iş birliğimiz kapsamında model 6 Ekim 2026 23:59'a (TSİ) kadar ücretsizdir.
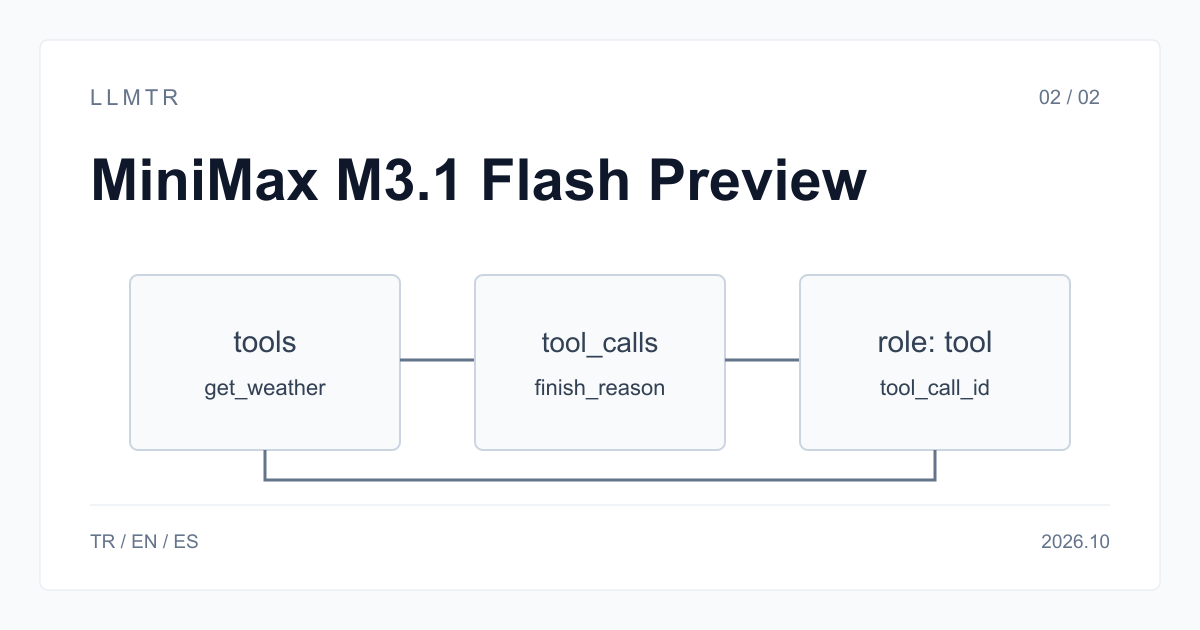
Döngü dört adımdan oluşur. Araçları tools alanında tanımlayın. Model bir aracı çağırmak isterse yanıtta finish_reason tool_calls olur ve message.tool_calls listesi gelir. Aracı kendi kodunuzda çalıştırın ve sonucu role tool ile, aynı tool_call_id değeriyle geri gönderin. Model finish_reason stop ile son yanıtı verene kadar tekrarlayın. Bu model /v1/responses ucundan sunulmaz; döngüyü Chat Completions üzerinde kurun.
Python örneği: adım sınırlı döngü
Örnek, OpenAI Python SDK'sının base_url ayarıyla LLMTR'ye bağlanır. Anahtarı koda yazmayın, LLMTR_API_KEY ortam değişkeninden okuyun. Döngü en fazla sekiz turla sınırlıdır: araç beklenmedik bir sonuç döndürdüğünde model aynı aracı tekrar çağırabilir ve sınır olmadan döngü kendiliğinden durmaz.
Modelin her yanıtını, araç çağrıları dahil, mesaj geçmişine olduğu gibi ekleyin; role tool mesajları ancak onları isteyen asistan mesajından sonra gelebilir. arguments alanı bir JSON metnidir; json.loads ile ayrıştırın ve aracı çalıştırmadan önce değerleri kendi kurallarınızla doğrulayın.
POST /v1/chat/completions üzerinde adım sınırlı ajan döngüsü
import json
import os

from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])
MODEL = "minimax/minimax-m3.1-flash-preview"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Bir şehrin güncel sıcaklığını Celsius olarak döndürür",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]


def get_weather(city: str) -> dict:
    return {"city": city, "celsius": 17}  # gerçek servisinizi burada çağırın


messages = [{"role": "user", "content": "Ankara'da şu an hava kaç derece?"}]

for step in range(8):  # adım sınırı: döngü sonsuza kadar sürmesin
    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        tools=tools,
        reasoning_effort="low",
        max_tokens=4000,
    )
    message = response.choices[0].message
    messages.append(message.model_dump(exclude_none=True))
    if not message.tool_calls:
        print(message.content)
        break
    for call in message.tool_calls:
        args = json.loads(call.function.arguments)
        result = get_weather(**args)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})
Ölçtüğümüz akış
1 Ekim 2026'da hava durumu aracıyla iki turlu bir döngüyü LLMTR üzerinden çalıştırdık (reasoning_effort low, max_tokens 4000). Yukarıdaki Python örneği aynı gün iki kez olduğu gibi çalıştırıldı; iki seferde de araç çağrısıyla başlayıp doğru sıcaklıkla bitti. İlk turda content alanı boş geldi, araç argümanları ise geçerli bir JSON metniydi. Aynı akışı Anthropic biçimindeki /v1/messages ucunda da denedik; orada araç çağrısı tool_use bloğu olarak geldi ve tool_result ile verilen sonuç doğru yanıtı üretti.
| Tur | Gönderilen | finish_reason | Gelen |
|---|---|---|---|
| 1 | Kullanıcı sorusu ve tools | tool_calls | get_weather çağrısı, arguments {"city": "Ankara"}; content boş |
| 2 | Asistan mesajı ve role tool sonucu | stop | Sıcaklığı söyleyen metin yanıtı |
Düşünme döngüde nasıl görünür
Model her turda önce düşünür. Akışsız yanıtta düşünme metni mesajda yer almaz; stream: true ile istek gönderirseniz düşünme metni delta.reasoning_content parçaları olarak, yanıt metninden önce gelir. Düşünme token'ları ayrı bir sayaçta gösterilmez, usage.completion_tokens değerine dahildir.
Denememizde asistan mesajını düşünme metni olmadan geçmişe eklemek yeterli oldu ve ikinci tur doğru yanıtı verdi. Her turda max_tokens değerine düşünme payı bırakın: sınır düşükse tur, araç çağrısı üretilmeden length ile kesilebilir. Kısa araç seçimlerinde reasoning_effort low yeterli oldu; çok adımlı planlamada daha yüksek bir seviye deneyin.
JSON, görsel ve sınırlar
Araç çağrısının yanında JSON nesne modu (response_format: json_object) çalışır. json_schema ile şemaya uyan çıktı garanti edilmez; hem son yanıtı hem araç argümanlarını kendi tarafınızda doğrulayın. Görseli OpenAI biçimindeki image_url parçasıyla gönderebilirsiniz; video girdisi bu kartta listelenmez. Araç açıklamalarını kısa ve net tutun; model hangi aracı ne zaman çağıracağına bu metinlere bakarak karar verir.
Bağlam penceresi 1.000.000 token, tek yanıtta en fazla 524.288 token üretilir. Uzun ajan oturumlarında mesaj geçmişi her turda yeniden gönderildiği için girdi turdan tura büyür. Model ücretsiz olduğu için bu bakiyenizden düşmez, ama eski araç sonuçlarını kısaltmak her isteği küçültür.
Hata yanıtları ve 6 Ekim sonrası
402 top_up_required: hesabınıza hiç bakiye yüklenmemiştir. En az 5 $ yükleyin ve bir dakika sonra tekrar deneyin; model bakiyenizden düşmez. 429: günlük ücretsiz kota dolmuştur ya da kısa sürede çok istek gönderilmiştir; turu hemen tekrarlamayın, üstel geri çekilme kullanın. 503 model_unavailable: model kapalı betada olduğu için geçici olarak yanıt vermeyebilir.
410 model_retired: 7 Ekim 2026'dan itibaren bu kimlik emeklidir ve yanıt minimax/minimax-m3 kimliğini önerir. Döngünüz 410'u geçici hata gibi tekrar denememeli, durup durumu bildirmelidir. M3 araç çağrısını destekler ama kartında reasoning_effort seviyesi ve JSON modu yoktur; geçişte bu alanları gövdeden çıkarın. Geçiş otomatik değildir.
MiniMax M3.1 Flash Preview ile araç çağıran bir ajan döngüsü kurma
OpenAI Python SDK'sı ve LLMTR'nin /v1/chat/completions ucuyla adım sınırlı bir tool calling döngüsü kurma adımları.
- Araçları tanımlayın. Her aracı tools listesine ad, açıklama ve JSON şemasıyla ekleyin.
- İsteği gönderin. model alanına minimax/minimax-m3.1-flash-preview yazın, reasoning_effort ve max_tokens değerlerini verin.
- Araç çağrılarını çalıştırın. finish_reason tool_calls ise her çağrıyı çalıştırın ve sonucu role tool ile aynı tool_call_id değeriyle ekleyin.
- Sınırla tekrarlayın. finish_reason stop gelene kadar, belirlediğiniz en fazla tur sayısına kadar tekrarlayın.
Sık sorulan sorular
MiniMax M3.1 Flash Preview tool calling destekliyor mu?
Evet. /v1/chat/completions ucunda tools alanıyla çalışır; model bir aracı çağırdığında finish_reason tool_calls olur. Anthropic biçimindeki /v1/messages ucunda da tool_use bloğu olarak gelir.
Araç sonucunu gönderirken düşünme metnini de eklemem gerekir mi?
1 Ekim 2026'daki denememizde gerekmedi: asistan mesajını düşünme metni olmadan eklemek yeterli oldu ve ikinci tur doğru yanıtı verdi.
Bu modeli /v1/responses ile kullanabilir miyim?
Hayır. İstek 400 unsupported_operation yanıtı alır. Ajan döngüsünü /v1/chat/completions üzerinde kurun.