RAG ve veri · 2026-10-12
Rusça metin için LLM API: özetleme ve sınıflandırma
Rusça metinleri OpenAI uyumlu API'yle işleyin: uzun belgeyi yandex/alice-ai-llm ile özetleyin, kısa mesajları yandex/yandexgpt-5-lite ile sınıflandırın.
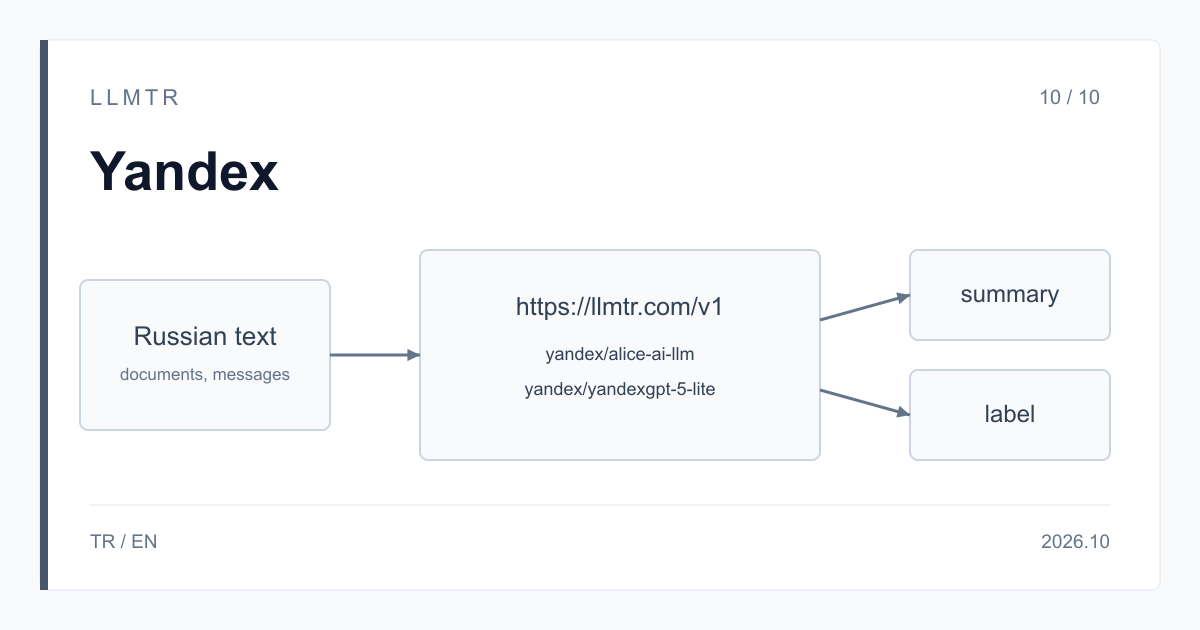
Kısa yanıt: uzun belge için yandex/alice-ai-llm, kısa mesajlar için yandex/yandexgpt-5-lite
LLMTR (llmtr.com), Türkiye'de ve global sağlayıcılarda barındırılan dil modellerine tek, OpenAI uyumlu API'den erişim veren bir gateway'dir. Rusça metni işlemek için istemcinizde yalnızca adres ve model kimliği değişir: uzun bir belgeyi yandex/alice-ai-llm ile özetler, çok sayıda kısa mesajı yandex/yandexgpt-5-lite ile sınıflandırırsınız. İki model de https://llmtr.com/v1 adresindeki /v1/chat/completions uç noktasından çağrılır.
İki model de Rusça dahil metin kabul eder ve metin döndürür. Rusça cevapların işinize uyup uymadığını üretime almadan önce kendi metinlerinizden bir örnek kümeyle deneyin.
Rusça metinler bir LLM API'siyle nasıl özetlenir ve sınıflandırılır?
İş ikiye ayrılır. Uzun bir rapor, sözleşme ya da yazışma dökümünü tek istekte özetlemek için bağlam penceresi belirleyicidir: Alice AI LLM 131.072 token bağlam sunar. Binlerce kısa mesajı sabit bir etiket kümesine ayırmak için ise istek başına maliyet belirleyicidir: YandexGPT 5 Lite'ta girdi ve çıktı 1 milyon token için 1,639344 $'dır ve bağlam 32.768 token'dır. Aşağıdaki tablo seçimi yalnızca bu iki kritere göre yapar.
| İş | Model | Gerekçe |
|---|---|---|
| Uzun Rusça belgeyi özetleme | yandex/alice-ai-llm | 131.072 token bağlam; girdi 4,09836 $, çıktı 9,836064 $ |
| Çok sayıda kısa Rusça mesajı sınıflandırma | yandex/yandexgpt-5-lite | 32.768 token bağlam; girdi ve çıktı 1,639344 $ |
Python örneği: Rusça istemle özet ve JSON etiket
Aşağıdaki örnek iki çağrı yapar. İlki bir dosyadaki Rusça belgeyi yandex/alice-ai-llm ile beş maddede özetler; sistem istemi cevabın Rusça olmasını açıkça ister. İkincisi kısa bir Rusça müşteri mesajını yandex/yandexgpt-5-lite ile dört etiketten birine ayırır ve sonucu response_format {"type": "json_object"} ile JSON olarak alır.
Özet çağrısı usage.prompt_tokens ile isteğin kaç token tuttuğunu ve finish_reason değerini yazdırır. Sınıflandırma çağrısında JSON çözülemezse ya da etiket listede yoksa kod varsayılan etikete düşer.
OpenAI Python SDK ile Rusça bir belgeyi yandex/alice-ai-llm ile özetleme ve kısa bir mesajı yandex/yandexgpt-5-lite ile JSON etikete ayırma.
import json
import os
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])

# 1. Summarize a long Russian document with Alice AI LLM.
with open("document_ru.txt", encoding="utf-8") as f:
    document = f.read()

summary = client.chat.completions.create(
    model="yandex/alice-ai-llm",
    messages=[
        {"role": "system", "content": "Ты аналитик. Отвечай только на русском языке."},
        {"role": "user", "content": "Кратко изложи документ в пяти пунктах.\n\n" + document},
    ],
    max_tokens=1000,
)
print(summary.choices[0].message.content)
print("prompt_tokens:", summary.usage.prompt_tokens)
print("finish_reason:", summary.choices[0].finish_reason)

# 2. Classify a short Russian message with YandexGPT 5 Lite and get JSON back.
LABELS = ["оплата", "доставка", "возврат", "другое"]
result = client.chat.completions.create(
    model="yandex/yandexgpt-5-lite",
    messages=[
        {
            "role": "system",
            "content": 'Определи тему сообщения клиента. Верни только JSON вида {"label": "<метка>"}, '
            "где метка - одно из значений: " + ", ".join(LABELS) + ".",
        },
        {"role": "user", "content": "Заказ пришёл без одной позиции, хочу вернуть деньги."},
    ],
    response_format={"type": "json_object"},
    temperature=0,
    max_tokens=20,
)
try:
    label = json.loads(result.choices[0].message.content).get("label")
except (AttributeError, TypeError, json.JSONDecodeError):
    label = None
print(label if label in LABELS else "другое")
Rusça metinlerde pratik ipuçları
Talimatı ve çıktı dilini istemde açıkça yazın. Cevabın hangi dilde olacağını, yalnızca JSON döndürülmesini ve etiketin hangi listeden seçileceğini istemde ayrı ayrı belirtin.
Token sayısını karakter sayısından tahmin etmeyin. Bir metnin kaç token tuttuğu metne göre değişir; gerçek değeri her yanıttaki usage.prompt_tokens alanından okuyun ve maliyet hesabını bu sayıyla yapın.
Sığmayan belgeleri bölün. Belge Alice AI LLM'in 131.072 token'lık bağlamına sığmıyorsa onu bölümlere ayırın, her bölümü ayrı özetleyin ve özetleri son bir istekte birleştirin. YandexGPT 5 Lite'ta bağlam 32.768 token'dır; uzun bir metni sınıflandırmanız gerekiyorsa önce özetleyin ya da yalnızca ilgili kısmı gönderin.
Etiketler için JSON kullanın. response_format {"type": "json_object"} gönderin ve istemde JSON beklediğinizi alan adlarıyla birlikte açıkça yazın; Yandex'in biçimlendirme sayfası da istemde JSON istendiğinin belirtilmesini önerir. Dönen etiketi her zaman kendi listenizle doğrulayın.
Maliyet: iki örnek hesap
Alice AI LLM'de 1 milyon token için girdi 4,09836 $, çıktı 9,836064 $'dır. 60.000 token'lık Rusça bir belgeyi 800 token'lık bir özete indirmek (60.000 x 4,09836 $ + 800 x 9,836064 $) / 1 milyon = 0,25377 $ tutar.
YandexGPT 5 Lite'ta girdi ve çıktı 1 milyon token için 1,639344 $'dır. Her biri 150 girdi ve 10 çıktı token'ı olan 10.000 mesaj toplam 1.600.000 token eder ve 1.600.000 x 1,639344 $ / 1 milyon = 2,62295 $ tutar.
LLMTR'deki 1 milyon token fiyatları Yandex'in yayımladığı USD liste fiyatlarıyla aynıdır; Yandex fiyatı 1.000 token başına verir. Fiyatlar 2026-10-12 tarihinde kontrol edildi. Bu modellerin fiyatına marj eklenmez; LLMTR'nin %8 platform payı yalnızca kredi yüklerken alınır.
Sınırlar: yalnızca metin, reasoning_effort yok
İki model de yalnızca metin kabul eder; görsel içeren bir istek 400 unsupported_input ile reddedilir ve ücretlendirilmez. reasoning_effort desteklenmez ve 400 invalid_request döner. finish_reason değeri length ise cevap kesilmiştir: uzun özetlerde bununla karşılaşırsanız max_tokens değerini yükseltip isteği tekrarlayın.
İki modelde de araç çağırma OpenAI tools biçimiyle çalışır ve stream: true ile akış açılabilir; usage, stream_options.include_usage ile akışın sonunda gelir.
LLMTR ile başlamak: hesap, anahtar ve ilk istek
Adım 1: llmtr.com'da bir hesap oluşturun ve ön ödemeli kredi yükleyin. Adım 2: Dashboard > API Anahtarları altında bir anahtar oluşturun; ham anahtar yalnızca bir kez gösterilir, onu LLMTR_API_KEY gibi bir ortam değişkeninde saklayın. Adım 3: OpenAI uyumlu SDK'nızda base_url değerini https://llmtr.com/v1 yapın, model olarak yandex/alice-ai-llm ya da yandex/yandexgpt-5-lite yazın ve ilk isteği gönderin.
Her istek, işlendiği andaki katalog fiyatıyla krediden düşülür; aynı anahtar katalogdaki her modelde çalışır.
Rusça metni LLMTR üzerinden özetleme ve sınıflandırma
Hesap açın, API anahtarı oluşturun ve yandex/alice-ai-llm ya da yandex/yandexgpt-5-lite ile https://llmtr.com/v1 adresine ilk isteği gönderin.
- Hesap. llmtr.com'da bir hesap oluşturun ve ön ödemeli kredi yükleyin.
- API anahtarı. Dashboard > API Anahtarları altında bir anahtar oluşturun. Ham anahtar yalnızca bir kez gösterilir; LLMTR_API_KEY ortam değişkeninde saklayın.
- İlk istek. OpenAI uyumlu bir SDK'da base_url değerini https://llmtr.com/v1 yapın ve model olarak yandex/alice-ai-llm ya da yandex/yandexgpt-5-lite ile ilk isteği gönderin.
Sık sorulan sorular
Rusça metin için hangi Yandex modelini seçmeliyim?
Uzun belgeleri özetlemek için 131.072 token bağlamlı yandex/alice-ai-llm, çok sayıda kısa mesajı sınıflandırmak için 32.768 token bağlamlı ve girdi ile çıktısı 1 milyon token için 1,639344 $ olan yandex/yandexgpt-5-lite uygundur. Sonucu kendi verinizle deneyin.
Rusça bir metnin kaç token tuttuğunu nasıl öğrenirim?
Karakter sayısından tahmin etmeyin. İsteği gönderin ve yanıttaki usage.prompt_tokens alanını okuyun; girdi maliyetini bu sayıyla hesaplayın.
Rusça sınıflandırma sonucunu JSON olarak alabilir miyim?
Evet. response_format {"type": "json_object"} gönderin ve istemde JSON beklediğinizi alan adlarıyla yazın. Dönen etiketi kendi listenizle doğrulayın.