RAG y datos · 2026-10-06
400 Bad Request: por qué embeddinggemma no admite chat
Solución para 400 Bad Request: embeddinggemma no admite chat. Usa /api/embed en Ollama o /v1/embeddings en LLMTR con llmtr/embeddinggemma-300m.
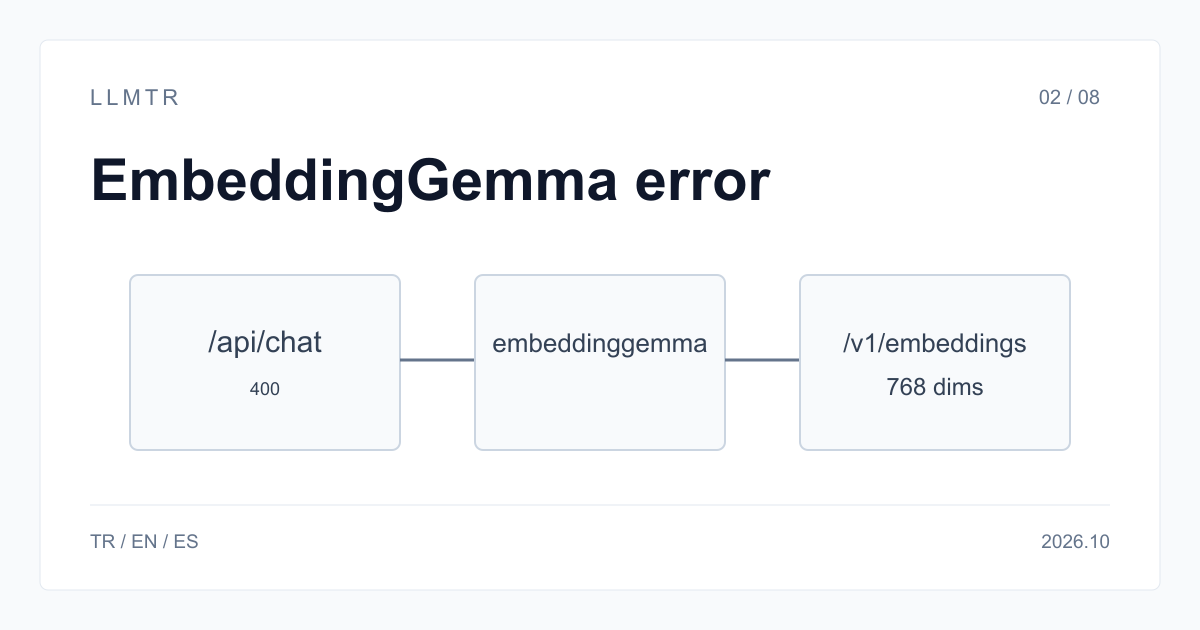
Respuesta corta: endpoint de embeddings para embeddinggemma
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. En LLMTR, llama a https://llmtr.com/v1 y usa el identificador llmtr/embeddinggemma-300m mediante /v1/embeddings. En Ollama, el nombre es embeddinggemma y la ruta es /api/embed.
El 400 aparece porque ese modelo transforma texto en vectores numéricos, pero no genera texto para una conversación. Si lo envías a /v1/chat/completions, LLMTR responde con HTTP 400 y un mensaje que indica el endpoint que debes usar. En Ollama, POST /api/embed genera embeddings, mientras /api/chat y /api/generate corresponden a generación de texto.
Error 400 Bad Request: "embeddinggemma" does not support chat, ¿qué significa?
Significa que has elegido una tarea de chat para un modelo de embeddings. En LLMTR, llmtr/embeddinggemma-300m solo está disponible en POST https://llmtr.com/v1/embeddings y produce vectores de 768 dimensiones, no una respuesta conversacional; EmbeddingGemma convierte el texto en vectores numéricos y no puede contestar una solicitud de chat.
En Ollama, la página de la biblioteca describe embeddinggemma como un modelo abierto de 300M parámetros, con contexto 2K, disponible desde la versión v0.11.10. La referencia separa POST /api/embed para embeddings de /api/chat y /api/generate para texto. La redacción exacta del mensaje no aparece allí, así que corrige la ruta del endpoint, no el texto del mensaje.
Cómo enviar cada llamada al endpoint correcto
La operación se determina por la salida que necesitas. Si quieres convertir textos en vectores para búsqueda, indexación o RAG, usa el endpoint de embeddings tanto en Ollama como en LLMTR. En ambos casos, el nombre del modelo y la ruta deben corresponder a la tarea.
Usa /api/embed con embeddinggemma en Ollama. En LLMTR, usa POST https://llmtr.com/v1/embeddings con llmtr/embeddinggemma-300m. El endpoint /v1/chat/completions es para chatting con un modelo de texto y no debe recibir este modelo de embeddings. La tabla conserva también el contexto y el tamaño del vector.
| Tarea | Ollama | LLMTR |
|---|---|---|
| Crear embeddings | POST /api/embed | POST https://llmtr.com/v1/embeddings |
| Chat con un modelo de texto | POST /api/chat | POST https://llmtr.com/v1/chat/completions |
| Nombre del modelo | embeddinggemma | llmtr/embeddinggemma-300m |
| Contexto por entrada | 2K tokens | 2.048 tokens |
| Tamaño del vector | — | 768 (truncable a 512, 256, 128) |
La solicitud correcta a LLMTR y la forma de respuesta
La solicitud POST de curl mostrada en esta sección envía dos textos a https://llmtr.com/v1/embeddings, usando llmtr/embeddinggemma-300m y Authorization con LLMTR_API_KEY. El input es un array: cada elemento se procesa como una entrada independiente. El modelo está alojado en Turquía, admite más de 100 idiomas, incluido el turco, y cuesta 0,10 $ por 1M tokens de entrada.
La respuesta usa data[]: cada entrada recibe un embedding con 768 números. Para el lote mostrado, data[] contiene un elemento por cada texto de input, y cada elemento contiene el vector de 768 dimensiones. llmtr/embeddinggemma-300m admite batch input y puede truncar el vector a 512, 256 o 128 dimensiones mediante MRL.
Ejemplo de solicitud por lotes a /v1/embeddings con dos entradas.
# Wrong: an embedding model on the chat endpoint returns 400 unsupported_operation.
# Right: send it to /v1/embeddings.
curl https://llmtr.com/v1/embeddings \
  -H "Authorization: Bearer $LLMTR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llmtr/embeddinggemma-300m",
    "input": ["İade süresi kaç gün?", "Kargo ücreti ne kadar?"]
  }'
# Each item in data[] carries an embedding of 768 numbers.
Causas comunes y soluciones
En un framework RAG, el error suele aparecer porque embeddinggemma quedó en el ajuste de modelo LLM/chat, en lugar del ajuste de modelo de embeddings. Coloca un modelo de chat en la ranura de chat y llmtr/embeddinggemma-300m en la ranura de embeddings. Después, verifica que la generación de texto y los vectores usan rutas separadas.
La segunda causa es llamar client.chat.completions.create con llmtr/embeddinggemma-300m: esa llamada devuelve el error 400. Cambia el método a client.embeddings.create y conserva base_url=https://llmtr.com/v1. No mezcles vectores de modelos distintos en un índice: indexa y consulta con el mismo modelo, porque sus vectores no son comparables.
Empezar en LLMTR: cuenta, crédito, clave y primera solicitud
Paso 1: crea una cuenta en llmtr.com y verifica tu correo electrónico. Paso 2: añade crédito desde el Dashboard mediante el proceso de pago seguro. El margen de plataforma del 8 % se añade una sola vez por encima de la cantidad solicitada; por ejemplo, una recarga de 10,00 $ cuesta 10,80 $. El margen no se aplica a los precios de los modelos: cada llamada se descuenta al precio de catálogo.
Paso 3: crea una API key en Dashboard > API Keys. La clave sin procesar se muestra una sola vez; guárdala en una variable de entorno como LLMTR_API_KEY. Paso 4: envía la primera solicitud a https://llmtr.com/v1 con cualquier SDK compatible con OpenAI y cambia solo base_url y api_key. La página de uso del Dashboard muestra el uso y el gasto por clave; la misma clave y el mismo saldo sirven para todos los modelos del catálogo. Para cambiar de modelo, modifica solo el identificador model.
Configurar llmtr/embeddinggemma-300m en LLMTR
Crea una cuenta, verifica el correo, recarga crédito y ejecuta una solicitud de embeddings con una clave de API.
- Cuenta. Crea una cuenta en llmtr.com y verifica tu correo electrónico.
- Recarga de crédito. Desde Dashboard, añade crédito mediante el proceso de pago seguro. El margen del 8 % se añade una vez; una recarga de 10,00 $ cuesta 10,80 $. Cada llamada se descuenta al precio de catálogo del modelo.
- Clave API. En Dashboard > API Keys, crea una clave. La clave sin procesar solo se muestra una vez; guárdala como LLMTR_API_KEY.
- Primera solicitud. Envía la primera solicitud a https://llmtr.com/v1/embeddings con un SDK compatible con OpenAI, cambiando solo base_url y api_key. El uso y el gasto por clave aparecen en la página de uso del Dashboard.
Frequently asked questions
¿Por qué embeddinggemma dice que no admite chat?
Es un modelo de embeddings: convierte texto en vectores numéricos y no genera texto. llmtr/embeddinggemma-300m devuelve vectores de 768 dimensiones y solo está disponible mediante POST https://llmtr.com/v1/embeddings en LLMTR.
¿Qué endpoint debo llamar para usar embeddinggemma?
En Ollama, llama a POST /api/embed; en LLMTR, llama a POST https://llmtr.com/v1/embeddings con llmtr/embeddinggemma-300m.
¿Cuántas dimensiones devuelve llmtr/embeddinggemma-300m?
Devuelve vectores de 768 dimensiones. El tamaño puede truncarse a 512, 256 o 128.