RAG y datos · 2026-10-06
Gemini 2.5 Flash: ¿modelo de embeddings o de chat?
Descubre si Gemini 2.5 Flash es un modelo de chat o de embeddings, compara las opciones de Gemini y aprende a usar la API de LLMTR en RAG.
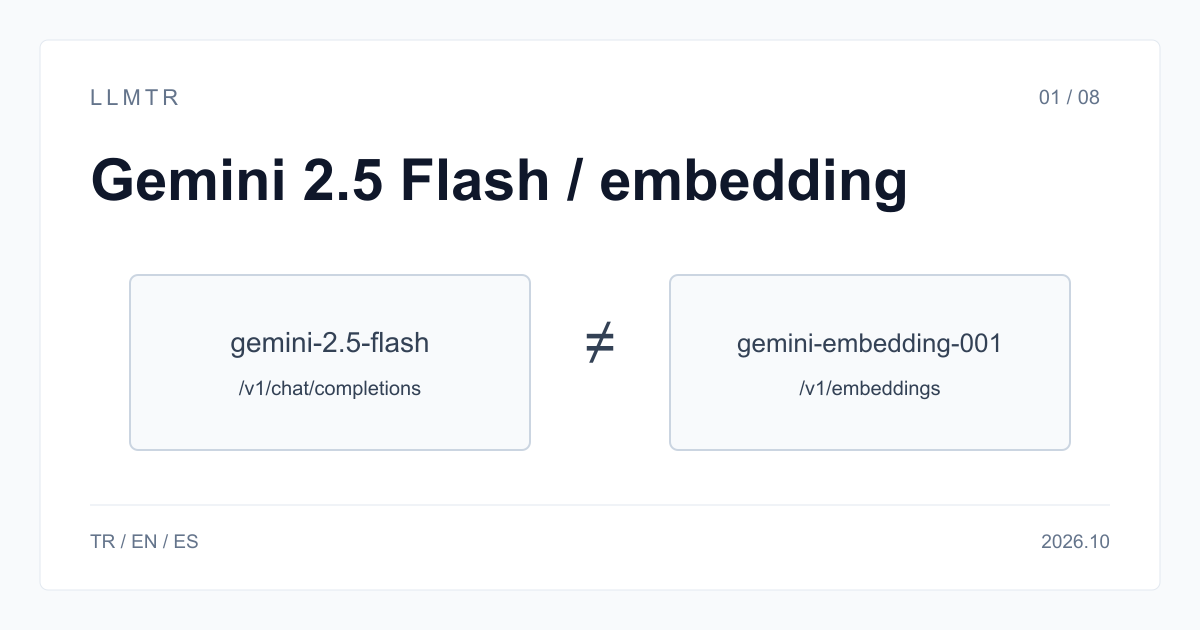
Respuesta corta: Gemini 2.5 Flash es un modelo de chat
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. Usa https://llmtr.com/v1, llama a google/gemini-2.5-flash en /v1/chat/completions o /v1/responses y reserva /v1/embeddings para google/gemini-embedding-001. Gemini 2.5 Flash no genera vectores de embedding.
Para una consulta RAG, usa google/gemini-embedding-001 al indexar documentos y formular la búsqueda, y usa google/gemini-2.5-flash después para leer los fragmentos recuperados y redactar la respuesta. Si una integración nueva necesita Flash a partir del 2026-10-16, el modelo indicado es google/gemini-3.6-flash.
| Identificador del modelo | Tipo | Endpoint | Contexto (tokens) | Precio por 1M tokens |
|---|---|---|---|---|
| google/gemini-2.5-flash | LLM (chat) | /v1/chat/completions, /v1/responses | 1.048.576 | $0.30 entrada, $2.50 salida |
| google/gemini-embedding-001 | Embedding (texto) | /v1/embeddings | 2.048 | $0.15 entrada |
| google/gemini-embedding-2-preview | Embedding (texto, imagen, audio, vídeo) | /v1/embeddings | 8.192 | $0.20 entrada de texto |
| llmtr/embeddinggemma-300m | Embedding (texto, alojado en Turquía) | /v1/embeddings | 2.048 | $0.10 entrada |
Gemini 2.5 Flash: ¿modelo de embeddings o modelo de chat?
Gemini 2.5 Flash es un modelo de chat: acepta texto, imagen, vídeo y audio, y devuelve texto. En la página de Google aparecen un límite de entrada de 1.048.576 tokens y uno de salida de 65.536 tokens para cada solicitud.
Para consultas de embeddings, usa un modelo específico en /v1/embeddings. En LLMTR, google/gemini-2.5-flash atiende /v1/chat/completions y /v1/responses, mientras que google/gemini-embedding-001 produce vectores de texto; Flash no ofrece un modo de embeddings. No debe enviarse al endpoint de vectores porque esa operación no está admitida.
Cómo distinguir los dos modelos antes de llamar
Consulta GET /v1/models/<id> sin clave de API y revisa supported_endpoints y architecture.modality. Para consultar los identificadores completos, usa https://llmtr.com/v1/models/<provider>/<slug>. El 2026-10-06, google/gemini-2.5-flash devolvió ['/v1/chat/completions', '/v1/responses'] con modality text+image+audio+video->text; google/gemini-embedding-001 devolvió ['/v1/embeddings'] con modality text->embedding. El ejemplo de Python consulta ambos identificadores y después crea una solicitud de embeddings con el segundo modelo.
Si envías google/gemini-2.5-flash a /v1/embeddings, LLMTR responde con HTTP 400 unsupported_operation. El mensaje empieza por "The model \"google/gemini-2.5-flash\" does not support /v1/embeddings. Use /v1/chat/completions instead."; corrige el endpoint a la ruta de chat, no el identificador, antes de reenviar la solicitud.
El ejemplo de Python consulta los dos modelos y después obtiene vectores con google/gemini-embedding-001.
import os
import requests
from openai import OpenAI

# 1) Check which endpoint a model serves. /v1/models needs no API key.
for model_id in ["google/gemini-2.5-flash", "google/gemini-embedding-001"]:
    info = requests.get(f"https://llmtr.com/v1/models/{model_id}", timeout=30).json()
    print(model_id, info["supported_endpoints"])
# google/gemini-2.5-flash ['/v1/chat/completions', '/v1/responses']
# google/gemini-embedding-001 ['/v1/embeddings']

# 2) Vectors come from the embedding model, not from the chat model.
client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])
result = client.embeddings.create(
    model="google/gemini-embedding-001",
    input=["Gemini 2.5 Flash is a chat model.", "gemini-embedding-001 returns vectors."],
)
print(len(result.data), len(result.data[0].embedding))
Qué modelo de embeddings elegir
Para texto, google/gemini-embedding-001 admite hasta 2.048 tokens por entrada y cuesta 0,15 $ por cada millón de tokens de entrada. Si indexes texto, imágenes, audio y vídeo en un mismo espacio vectorial, google/gemini-embedding-2-preview admite hasta 8.192 tokens y cobra 0,20 $ por cada millón de tokens de texto.
llmtr/embeddinggemma-300m es una alternativa alojada en Turquía: genera vectores de 768 dimensiones, que pueden truncarse a 512, 256 o 128, admite hasta 2.048 tokens y cuesta 0,10 $ por cada millón de tokens de entrada. Indexa y consulta siempre con el mismo modelo: los vectores de modelos distintos no son comparables, y cambiar de modelo obliga a volver a generar los embeddings del corpus.
Dónde encaja Gemini 2.5 Flash en RAG
En una canalización RAG, el modelo de embeddings convierte los documentos y la pregunta en vectores para recuperar fragmentos. Gemini 2.5 Flash lee los fragmentos recuperados y escribe la respuesta; no interviene en la generación de esos vectores ni debe sustituir al modelo del índice.
Google retira gemini-2.5-flash el 2026-10-16. Desde esa fecha, LLMTR rechaza las solicitudes con HTTP 410 y el código model_retired. Las integraciones nuevas deben comenzar con google/gemini-3.6-flash, sin cambiar el diseño RAG basado en recuperar fragmentos y generar una respuesta final.
Empezar en LLMTR: cuenta, crédito, clave y primera solicitud
Crea una cuenta en llmtr.com y verifica tu correo. Después, añade crédito desde el Dashboard mediante el checkout seguro. La plataforma aplica una sola vez un margen del 8 % sobre la recarga solicitada: si pides 10,00 $, se cobran 10,80 $. Ese margen no se añade a los precios de los modelos; cada llamada se descuenta al precio del catálogo.
Ve a Dashboard > API Keys, crea una clave y guárdala como variable de entorno, por ejemplo LLMTR_API_KEY. La clave API en texto claro se muestra una sola vez. Para la primera solicitud, usa cualquier SDK compatible con OpenAI y cambia únicamente base_url por https://llmtr.com/v1 y api_key por tu clave. La misma clave y el mismo saldo sirven para todo el catálogo: cambiar de modelo significa cambiar su identificador. La página de uso del Dashboard muestra el uso y el gasto por clave.
Configurar embeddings en LLMTR
Crea la cuenta, prepara el crédito, genera una clave y envía tu primera solicitud de embeddings.
- Cuenta. Crea una cuenta en llmtr.com y verifica tu correo.
- Recarga de crédito. Desde el Dashboard, abre el checkout seguro y recarga el crédito. Se añade una sola vez un margen de plataforma del 8 %: una recarga de 10,00 $ se cobra 10,80 $. El margen no se añade a los precios de los modelos.
- Clave API. Crea una clave en Dashboard > API Keys. El valor en texto claro aparece una sola vez, así que guárdalo en LLMTR_API_KEY o en otra variable de entorno segura.
- Primera solicitud. Configura un SDK compatible con OpenAI con base_url=https://llmtr.com/v1 y api_key=LLMTR_API_KEY. Envía POST a https://llmtr.com/v1/embeddings usando model=google/gemini-embedding-001.
Frequently asked questions
¿Gemini 2.5 Flash es un LLM o un modelo de embeddings?
Es un LLM de chat, con una entrada de hasta 1.048.576 tokens y salida de texto de hasta 65.536 tokens. Los vectores proceden de google/gemini-embedding-001 o google/gemini-embedding-2-preview.
¿Qué modelo de Gemini debo usar para embeddings de texto o contenido mixto?
Usa google/gemini-embedding-001 para texto: admite 2.048 tokens por entrada y cuesta 0,15 $ por cada millón de tokens de entrada. Para texto, imagen, audio y vídeo en un mismo espacio vectorial, usa google/gemini-embedding-2-preview.
¿Qué ocurre si envío Gemini 2.5 Flash a /v1/embeddings?
Devuelve HTTP 400 con unsupported_operation y un mensaje que indica que el modelo no admite /v1/embeddings. LLMTR indica usar /v1/chat/completions.