Flujos de agentes · 2026-10-10
Agente con herramientas y Mistral Large 4: tool_choice y razonamiento
Bucle de agente con mistral/mistral-large-4 en LLMTR: opciones de tool_choice, función con nombre en lugar de required y reenvío de reasoning_content.
Respuesta corta: llama a herramientas, pero no admite tool_choice required
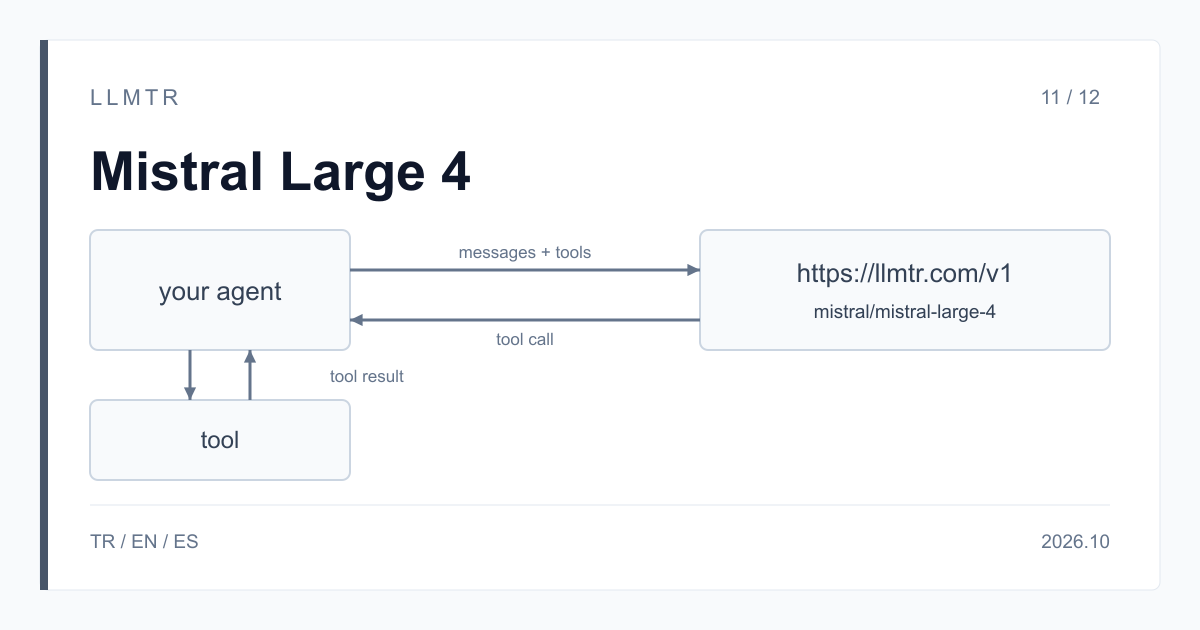
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. En un agente con herramientas, Mistral Large 4 se usa con el id de modelo mistral/mistral-large-4 en el endpoint /v1/chat/completions de https://llmtr.com/v1. Las herramientas se definen en el array tools al estilo de OpenAI, el modelo devuelve la llamada en tool_calls y tú envías el resultado en un mensaje role: "tool".
Mistral orienta Large 4 a la programación y a los flujos de agentes. Al montar un agente hay que saber tres cosas: en tool_choice funcionan auto, none y una función con nombre, pero no required; el modelo puede llamar a más de una herramienta en una sola respuesta; y los mensajes anteriores del asistente se reenvían con su campo reasoning_content.
Cómo crear un agente con llamadas a herramientas con Mistral Large 4
El bucle de Python de abajo define una herramienta de consulta de pedidos con el SDK de OpenAI. En cada turno, el mensaje del asistente se añade al historial tal como llega, con model_dump(exclude_none=True), así que se conserva reasoning_content. Si el modelo no llamó a ninguna herramienta, el bucle imprime la respuesta y termina. Si llamó, ejecuta la herramienta para cada elemento de tool_calls y añade el resultado como mensaje role: "tool" con su tool_call_id.
Pon un límite de turnos al bucle (5 en el ejemplo) y deja max_tokens en unos miles de tokens. El razonamiento está activo por defecto; sus tokens salen del presupuesto de max_tokens y se facturan al precio de salida. Una respuesta con finish_reason igual a length está incompleta: sube el presupuesto y repite ese turno.
Bucle de agente con el SDK de OpenAI para Python que usa la herramienta lookup_order y conserva los mensajes del asistente con reasoning_content.
import json
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key="llmtr-your_key")

def lookup_order(order_id: str) -> dict:
    return {"order_id": order_id, "status": "shipped"}

tools = [{
    "type": "function",
    "function": {
        "name": "lookup_order",
        "description": "Fetches an order by its order number",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    },
}]

messages = [{"role": "user", "content": "Where are orders 4417 and 4418?"}]
for _ in range(5):
    response = client.chat.completions.create(
        model="mistral/mistral-large-4",
        messages=messages,
        tools=tools,
        tool_choice="auto",
        max_tokens=4096,
    )
    message = response.choices[0].message
    # Keep reasoning_content: the model reads its earlier reasoning from it.
    messages.append(message.model_dump(exclude_none=True))
    if not message.tool_calls:
        print(message.content)
        break
    for call in message.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(lookup_order(**args)),
        })
tool_choice: auto, none, función con nombre y required
Con auto el modelo decide si llama a una herramienta, y con varias herramientas es la opción adecuada para la mayoría de los turnos; indica en el prompt qué herramienta usar y cuándo. none desactiva las llamadas. Para que una herramienta sea obligatoria, nombra la función. La solicitud curl de abajo obliga a usar lookup_order por su nombre y desactiva el razonamiento.
tool_choice: "required" no está disponible en este modelo: la solicitud se rechaza con 400 invalid_request y error.details.reason lleva tool_choice_required_unsupported. Si pasas a Large 4 un agente que envía required, usa el nombre de la función cuando haya una sola herramienta, o auto con una instrucción en el prompt cuando haya varias.
| tool_choice | Resultado |
|---|---|
| auto | El modelo decide si llama a una herramienta |
| none | No se llama a ninguna herramienta; el modelo responde con texto |
| {"type": "function", "function": {"name": "lookup_order"}} | Se llama a la función indicada |
| required | 400 invalid_request, error.details.reason: tool_choice_required_unsupported |
Solicitud curl que obliga a usar la función lookup_order por su nombre y envía reasoning_effort none.
curl https://llmtr.com/v1/chat/completions \
  -H "Authorization: Bearer $LLMTR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral/mistral-large-4",
    "reasoning_effort": "none",
    "max_tokens": 512,
    "messages": [{"role": "user", "content": "Fetch order 4417."}],
    "tools": [{
      "type": "function",
      "function": {
        "name": "lookup_order",
        "description": "Fetches an order by its order number",
        "parameters": {
          "type": "object",
          "properties": {"order_id": {"type": "string"}},
          "required": ["order_id"]
        }
      }
    }],
    "tool_choice": {"type": "function", "function": {"name": "lookup_order"}}
  }'
Llamadas en paralelo y resultados de herramientas
El modelo puede devolver más de una llamada a herramientas en una respuesta; la pregunta con dos pedidos del ejemplo puede producir dos llamadas a lookup_order. Procesa todo el array tool_calls y añade cada resultado como un mensaje role: "tool" aparte con su tool_call_id; no dejes ninguna llamada sin resultado. Si quieres las llamadas de una en una, envía parallel_tool_calls: false.
Mantén los resultados cortos y estructurados: cada resultado del historial cuenta como tokens de entrada en los turnos siguientes. Si la respuesta final del agente debe seguir un esquema, puedes enviar response_format con json_schema y strict: true.
Reenviar el razonamiento y el coste de los turnos
En una conversación de varios turnos, reenvía los mensajes anteriores del asistente tal como los recibiste, con reasoning_content. El modelo lee de ese campo lo que razonó en el turno anterior, y la coherencia entre turnos de un bucle con herramientas depende de ello. El razonamiento reenviado se factura como tokens de entrada. Si quitas el campo gastas menos tokens, pero el modelo ya no sabe qué decidió antes.
Un ejemplo: un razonamiento de 1.500 tokens reenviado como entrada en el turno siguiente, sin leerse de caché, cuesta 1.500 x 0,68 $ / 1M = 0,00102 $ hasta el 20 de octubre de 2026 a las 00:00 UTC, y 0,00204 $ a 1,36 $ a partir de entonces. Para bajar el coste no se borra el razonamiento: se activa solo donde ayuda. En turnos de enrutamiento simples, donde la herramienta es evidente, usa reasoning_effort: "none" o mistral/mistral-large-4:none; en turnos de planificación o de combinar resultados, high. El nivel se elige en cada solicitud.
Límites y cómo empezar en LLMTR
La salida por respuesta es de 262.144 tokens como máximo; un max_tokens mayor devuelve 400. La ventana de contexto es de 524.288 tokens y los historiales largos de herramientas deben caber en ella. temperature va de 0 a 1,5; seed y user devuelven 422. En streaming, el razonamiento llega en delta.reasoning_content y la respuesta en delta.content.
Para empezar, crea una cuenta en llmtr.com, recarga crédito prepago y crea una clave en Dashboard > API Keys; usa https://llmtr.com/v1 como base_url en el bucle de arriba. Cada solicitud se descuenta del crédito al precio del catálogo vigente cuando se procesa, y la página de uso muestra el coste del agente por clave y por modelo.
Crear un agente con herramientas con Mistral Large 4
Define una herramienta, monta el bucle con mistral/mistral-large-4 y conserva los mensajes del asistente con reasoning_content en el historial.
- Definir la herramienta. Define la función en el array tools con su nombre, descripción y parámetros en JSON Schema.
- tool_choice. Usa auto con varias herramientas y nombra la función cuando haya una sola obligatoria; no envíes required.
- Bucle. Añade el mensaje del asistente con reasoning_content, añade el resultado de cada tool_calls como mensaje role tool y pon un límite de turnos.
Frequently asked questions
¿Mistral Large 4 admite tool_choice required?
No. Una solicitud con tool_choice: "required" devuelve 400 invalid_request con tool_choice_required_unsupported en error.details.reason. Para que una herramienta sea obligatoria, nombra la función.
¿Hay que reenviar reasoning_content a Mistral Large 4?
Sí. En conversaciones de varios turnos y bucles con herramientas, reenvía los mensajes anteriores del asistente con reasoning_content; el modelo lee de ahí su razonamiento anterior. Ese razonamiento reenviado se factura como tokens de entrada.
¿Puede Mistral Large 4 llamar a varias herramientas a la vez?
Sí, una respuesta puede traer más de un elemento en tool_calls. Procésalos todos y añade cada resultado como su propio mensaje role: "tool", o envía parallel_tool_calls: false para recibir las llamadas de una en una.