Comparativa de modelos · 2026-10-10
¿Mistral Large 4 o Large 3? Contexto, razonamiento y precio
mistral/mistral-large-4 frente a mistral/mistral-large-latest (Large 3): contexto, niveles de razonamiento, precio con fecha y coste de una misma solicitud.
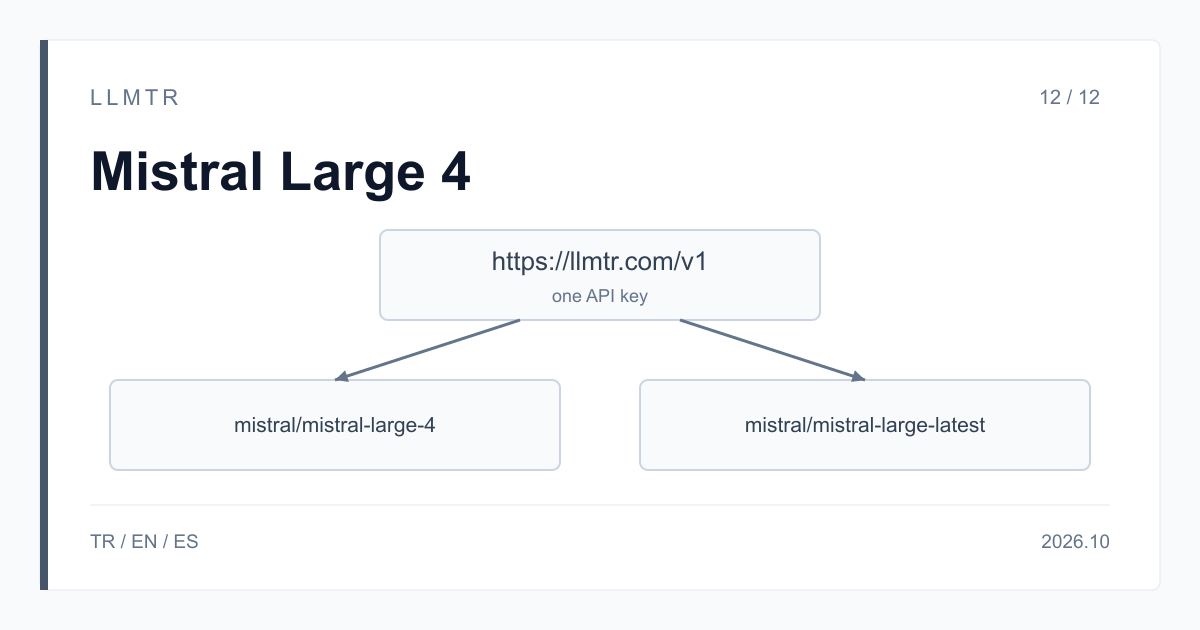
Respuesta corta: los dos están en la misma API y se cambia con el id del modelo
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. Allí Mistral Large 4 se ofrece como mistral/mistral-large-4 y Mistral Large 3 como mistral/mistral-large-latest; ambos se llaman en el endpoint /v1/chat/completions de https://llmtr.com/v1 con la misma clave de API. Pasar de uno a otro es cambiar el nombre del modelo.
Las diferencias están en tres puntos. Large 4 ofrece 524.288 tokens de contexto y Large 3, 256.000. Large 4 razona por defecto antes de responder y reasoning_effort elige none o high; la fila de Large 3 no tiene niveles de reasoning_effort. En precio, Large 4 tiene dos tarifas con fecha y Large 3 un único precio. En el catálogo de LLMTR, Large 4 figura como un modelo grande de la familia más nuevo que Large 3.
¿Mistral Large 4 o Mistral Large 3? Cuál elegir
Si trabajas con documentos, bases de código o historiales de más de 256.000 tokens, decide la ventana de contexto: un prompt que no cabe en Large 3 puede caber en Large 4. Para análisis de varios pasos, planificación y agentes con herramientas, los niveles de razonamiento de Large 4 dan un control: high en los turnos difíciles, none en los simples.
En trabajos de alto volumen con respuestas cortas, prueba ambos con tus propios ejemplos y mira los tokens. Los tokens que Large 4 genera al razonar se facturan como salida; con none la salida es solo la respuesta. La tabla muestra los valores del catálogo de LLMTR.
| Característica | mistral/mistral-large-4 | mistral/mistral-large-latest |
|---|---|---|
| Modelo | Mistral Large 4 | Mistral Large 3 |
| Ventana de contexto | 524.288 tokens | 256.000 tokens |
| Entrada | texto, imagen | texto, imagen |
| Llamadas a herramientas | sí; sin tool_choice required | sí |
| reasoning_effort | none, high (razonamiento activo por defecto) | sin niveles |
| Entrada / salida (por 1M de tokens) | 0,68 $ / 2,09 $ hasta el 20 de octubre de 2026, 00:00 UTC; después 1,36 $ / 4,18 $ | 0,50 $ / 1,50 $ |
¿Cuánto cuesta la misma solicitud en cada modelo?
Tomemos una solicitud de 10.000 tokens de entrada y 2.000 de salida. En Large 3 cuesta (10.000 x 0,50 $ + 2.000 x 1,50 $) / 1M = 0,00800 $. En Large 4, con los mismos tokens, cuesta 0,01098 $ hasta el 20 de octubre de 2026 a las 00:00 UTC (03:00, hora de Turquía) y 0,02196 $ a partir de entonces.
El cálculo supone que los dos modelos generan los mismos tokens de salida. Con el razonamiento activo, la salida de Large 4 incluye el razonamiento además de la respuesta, así que la diferencia real depende de la tarea, y reasoning_effort: "none" la reduce. En Large 4 la entrada leída de caché cuesta 0,07 $ hasta el 20 de octubre y 0,14 $ después. El changelog de Mistral del 6 de octubre de 2026 anunció el precio de lanzamiento de Large 4 como un 50 % de descuento durante dos semanas; en LLMTR la tarifa cambia sola.
Diferencias en razonamiento y llamadas a herramientas
Large 4 razona por defecto; el razonamiento llega en reasoning_content y la respuesta en content. Solo acepta none y high; minimal, low, medium, xhigh y max devuelven 400. En conversaciones de varios turnos, reenvía los mensajes anteriores del asistente con reasoning_content; ese razonamiento se factura como entrada. La fila de Large 3 no tiene niveles de reasoning_effort, así que envía ese campo solo a Large 4.
Los dos modelos aceptan el array tools al estilo de OpenAI. En Large 4, tool_choice admite auto, none y una función con nombre; "required" devuelve 400 invalid_request con tool_choice_required_unsupported en error.details.reason.
El id mistral/mistral-large-latest está fijado en Large 3
Aunque su nombre diga latest, en LLMTR el id mistral/mistral-large-latest llama a Mistral Large 3 y no pasa solo a Large 4. Así, el comportamiento y la factura de las aplicaciones que usan este id no cambian sin aviso. Para usar Large 4, pon explícitamente mistral/mistral-large-4; si tu código envía tool_choice: "required", cámbialo al nombre de la función.
Antes de cambiar, ejecuta los dos modelos con los mismos prompts y compara los tokens. El ejemplo de abajo envía un prompt a ambos, pasa reasoning_effort: "none" a Large 4 pero no a Large 3 e imprime los tokens de entrada y salida de cada uno.
Envía el mismo prompt a mistral/mistral-large-latest y a mistral/mistral-large-4 e imprime el uso de tokens de ambos.
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key="llmtr-your_key")

prompt = [{"role": "user", "content": "Summarize the risks in this contract clause in three bullet points."}]

for model, extra in [
    ("mistral/mistral-large-latest", {}),
    ("mistral/mistral-large-4", {"reasoning_effort": "none"}),
]:
    response = client.chat.completions.create(
        model=model,
        messages=prompt,
        max_tokens=1024,
        **extra,
    )
    print(model, response.usage.prompt_tokens, response.usage.completion_tokens)
    print(response.choices[0].message.content)
Probar los dos modelos en LLMTR con una sola clave
Crea una cuenta en llmtr.com, recarga crédito prepago y crea una clave en Dashboard > API Keys. En tu SDK compatible con OpenAI, pon https://llmtr.com/v1 como base_url; la misma clave sirve para los dos modelos. Cada solicitud se descuenta del crédito al precio vigente del catálogo y aparece en la página de uso por modelo, con el coste real de ambos.
Pasar de Mistral Large 3 a Large 4
Prueba los dos modelos con la misma clave, adapta el código y cambia el id a mistral/mistral-large-4.
- Prueba en paralelo. Envía los mismos prompts a mistral/mistral-large-latest y a mistral/mistral-large-4 y compara los tokens.
- Cambios en el código. Cambia tool_choice required por el nombre de la función y reenvía reasoning_content.
- Id del modelo. Pon mistral/mistral-large-4 como modelo y, si hace falta, elige none o high con reasoning_effort.
Frequently asked questions
¿Qué diferencia hay entre Mistral Large 4 y Large 3?
En LLMTR, Large 4 ofrece 524.288 tokens de contexto y Large 3, 256.000. Large 4 razona por defecto y acepta los niveles none y high. Por 1M de tokens, la entrada / salida cuesta 0,68 $ / 2,09 $ en Large 4 hasta el 20 de octubre de 2026 a las 00:00 UTC y después 1,36 $ / 4,18 $; Large 3 cuesta 0,50 $ / 1,50 $.
¿mistral/mistral-large-latest llama a Mistral Large 4?
No. En LLMTR, mistral/mistral-large-latest está fijado en Large 3 y no pasa solo a Large 4. Para Large 4, usa el id mistral/mistral-large-4.
¿Qué cambia en el código al pasar de Large 3 a Large 4?
Cambia el nombre del modelo. Si usas tool_choice: "required", pásalo al nombre de la función y reenvía reasoning_content en las conversaciones de varios turnos.