Guías de integración · 2026-10-10
Entrada de video e imagen con Step 5 Preview: una solicitud a la API con base64
Envía video e imágenes a Step 5 Preview como data URL en base64: partes video_url e image_url, formatos, el límite de 9 MB y la facturación.
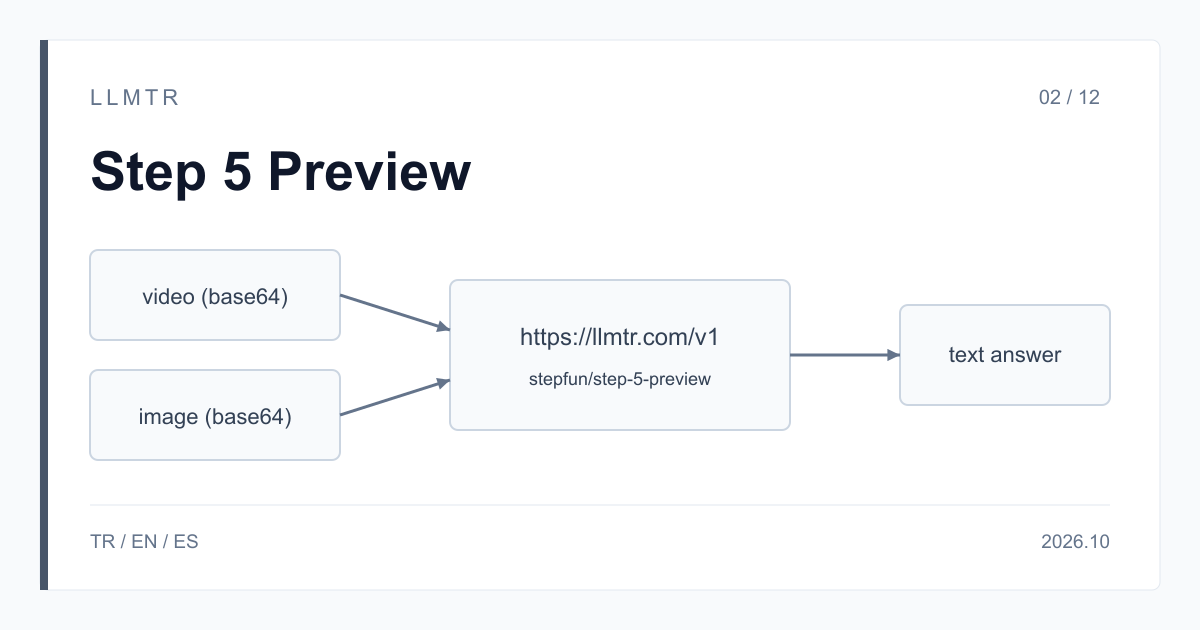
Respuesta corta: el video y la imagen van dentro del mensaje como data URL en base64
LLMTR (llmtr.com) es un gateway que da acceso, a través de una única API compatible con OpenAI, a modelos de lenguaje alojados en Turquía y en proveedores globales. A StepFun Step 5 Preview le envías video e imágenes dentro del mensaje de una solicitud al endpoint https://llmtr.com/v1/chat/completions, como data URL en base64. El id del modelo es stepfun/step-5-preview; la imagen va en una parte image_url, el video en una parte video_url, y una parte de texto del mismo mensaje lleva la pregunta. En el cliente, la URL base es https://llmtr.com/v1.
El modelo lee la imagen o el video y devuelve la respuesta en texto; no genera imágenes ni video. Los medios cuentan como tokens de entrada y se facturan a 1,00 $ por 1M de tokens. La ventana de contexto es de 1.024.000 tokens; si reenvías el historial con sus medios, esos medios se cuentan otra vez.
Cómo enviar video e imágenes a Step 5 Preview
Codifica el video en base64 y ponlo en una parte video_url con el prefijo data:video/mp4;base64,. Añade al array content del mismo mensaje una parte de texto con la pregunta. La solicitud curl de abajo pregunta por los pasos de un pago fallido en una grabación de pantalla; el texto base64 está acortado en el ejemplo.
Una imagen usa una parte image_url con la misma estructura, y su url empieza por data:image/png;base64,. Un mensaje puede llevar partes de texto, imagen y video juntas, con un máximo de 16 partes de contenido. Las referencias stepfile:// de la Files API de StepFun no se aceptan a través de LLMTR; envía el archivo en base64.
Solicitud curl que envía una grabación de pantalla como data:video/mp4;base64 con reasoning_effort low (texto base64 acortado).
curl https://llmtr.com/v1/chat/completions \
  -H "Authorization: Bearer $LLMTR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "stepfun/step-5-preview",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "This screen recording shows a failed checkout. List the steps the user took and where the error appears."},
        {"type": "video_url", "video_url": {"url": "data:video/mp4;base64,AAAAIGZ0eXBpc29t..."}}
      ]
    }],
    "reasoning_effort": "low",
    "max_tokens": 2048
  }'
Formatos admitidos y límites de tamaño
StepFun acepta JPG, PNG, WebP y GIF estático para imágenes. Para video, LLMTR usa los prefijos data:video/mp4 y data:video/quicktime. El video enviado en base64 tiene un límite de unos 9 MB.
Para una grabación más larga, recorta el video, baja su resolución o divídelo en clips y envía cada clip en su propia solicitud; después combina las respuestas en una solicitud de resumen. Si sabes qué escenas importan, enviar solo esas partes reduce los tokens de entrada.
| Elemento | Valor |
|---|---|
| Parte de imagen | image_url, data:image/...;base64 |
| Formatos de imagen | JPG, PNG, WebP, GIF estático |
| Parte de video | video_url, data:video/mp4;base64 o data:video/quicktime;base64 |
| Límite del video en base64 | unos 9 MB |
| Referencias stepfile:// | no se aceptan |
| Partes de contenido por mensaje | como máximo 16 |
| Precio de entrada (por 1M de tokens) | 1,00 $ |
Codificar una imagen en base64 y enviarla desde Python
Con el SDK de OpenAI para Python, leer una imagen y codificarla en base64 lleva dos líneas. El ejemplo de abajo pregunta por el mensaje de error de una captura de pantalla; el mismo patrón sirve para una foto de producto, un gráfico o un formulario escaneado.
reasoning_effort low es un buen punto de partida para una pregunta corta sobre una imagen; para comparar varias imágenes o sacar una conclusión de un gráfico, prueba medium o high. El modelo razona en todos los niveles y los tokens de razonamiento salen del presupuesto de max_tokens. Trata como incompleta una respuesta con finish_reason length y sube el presupuesto.
Ejemplo con el SDK de OpenAI para Python que pone una captura PNG en una parte image_url como data URL en base64.
import base64
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key="llmtr-your_key")

with open("screenshot.png", "rb") as f:
    image_b64 = base64.b64encode(f.read()).decode("ascii")

response = client.chat.completions.create(
    model="stepfun/step-5-preview",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "What error message is shown in this screenshot?"},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_b64}"}},
        ],
    }],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.usage.prompt_tokens)
¿Cómo se facturan la imagen y el video de entrada?
No hay un precio unitario aparte para imágenes o video: los medios cuentan como tokens de entrada y se facturan a 1,00 $ por 1M de tokens. Puedes ver cuántos tokens de entrada usó una solicitud en usage.prompt_tokens. La respuesta y el razonamiento son tokens de salida y se facturan a 2,70 $ por 1M de tokens.
Si vas a hacer varias preguntas sobre el mismo video, ponlas en un solo mensaje, porque cada solicitud vuelve a enviar los medios y se cuentan de nuevo. Lo mismo pasa al reenviar el historial con sus partes de medios. Si el turno siguiente no necesita los medios, dejar en el historial solo la respuesta en texto del modelo reduce los tokens de entrada.
Casos de uso y cómo empezar con LLMTR
Usos habituales: sacar los pasos de un usuario de una grabación adjunta a un informe de error, preguntar si una demo de producto sigue una lista de control, leer el mensaje de error de una captura o pasar a una tabla los valores de un gráfico. Si quieres procesar el resultado en código, pasa json_schema en response_format; Step 5 Preview devuelve JSON que se ajusta a tu esquema.
Para empezar, crea una cuenta en llmtr.com, crea una clave en Dashboard > API Keys y envía una de las solicitudes anteriores a https://llmtr.com/v1 con stepfun/step-5-preview como modelo. La misma clave sirve para todos los modelos del catálogo y las solicitudes se descuentan del crédito prepago al precio del catálogo.
Enviar video o una imagen a Step 5 Preview
Codifica el archivo en base64, añádelo al mensaje como data URL y envíalo a https://llmtr.com/v1/chat/completions con stepfun/step-5-preview.
- Base64. Codifica el video o la imagen en base64. El video en base64 tiene un límite de unos 9 MB.
- Parte. Añade la imagen como parte image_url o el video como parte video_url, con data URL, al array content del mensaje; escribe la pregunta en una parte de texto.
- Solicitud. Envía la solicitud a https://llmtr.com/v1/chat/completions con stepfun/step-5-preview como modelo y lee la respuesta en message.content.
Frequently asked questions
¿Step 5 Preview entiende video?
Sí. Añade el video como parte video_url en formato data:video/mp4;base64 a una solicitud a https://llmtr.com/v1/chat/completions; el modelo lee el video y responde en texto.
¿Cuántas imágenes puedo enviar a Step 5 Preview en un mensaje?
A través de LLMTR un mensaje lleva como máximo 16 partes de contenido, y la parte de texto con la pregunta cuenta dentro de ese número. Para más imágenes, reparte el trabajo en varias solicitudes.
¿La imagen y el video de entrada se cobran aparte?
No, no hay un precio unitario aparte. Los medios cuentan como tokens de entrada y se facturan a 1,00 $ por 1M de tokens; el recuento aparece en usage.prompt_tokens.