Comparativa de modelos · 2026-10-10
¿Step 5 Preview o Step 3.7 Flash? Contexto y coste para trabajo con agentes
Compara Step 5 Preview y Step 3.7 Flash: contexto de 1.024.000 y 256.000 tokens, precios por 1M de tokens, json_schema y el coste de un turno de agente.
Respuesta corta: elige según la longitud del contexto y el esquema
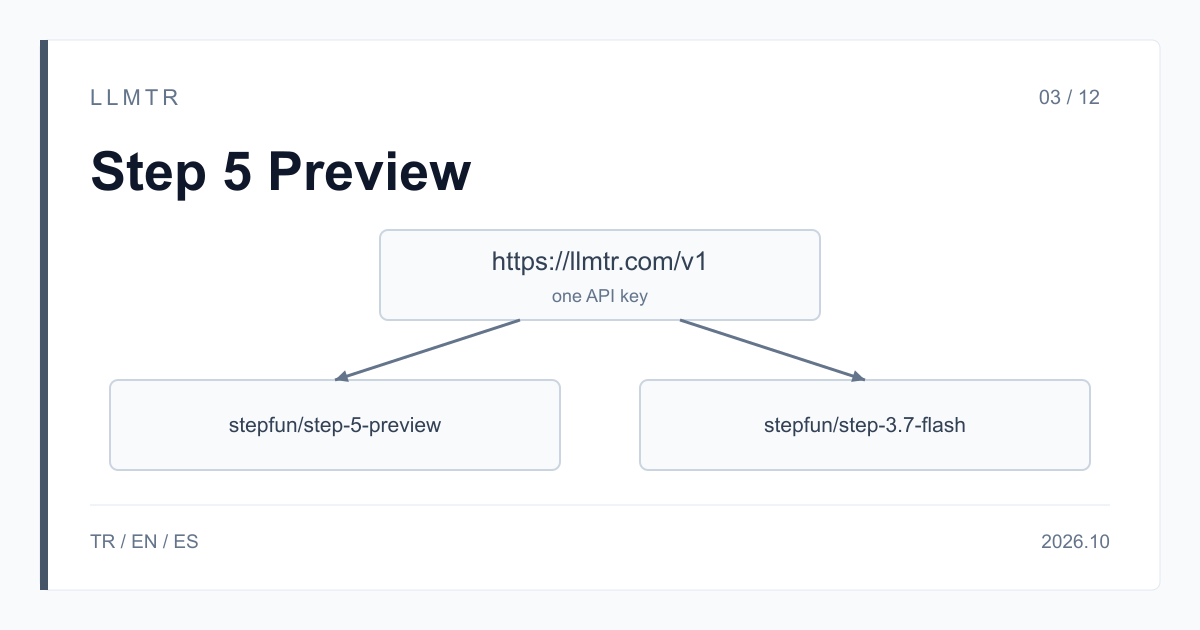
LLMTR (llmtr.com) es un gateway que da acceso, a través de una única API compatible con OpenAI, a modelos de lenguaje alojados en Turquía y en proveedores globales. Los dos modelos de StepFun se llaman con la misma clave de LLMTR en el endpoint https://llmtr.com/v1/chat/completions. stepfun/step-5-preview tiene un contexto de 1.024.000 tokens y cuesta 1,00 $ por 1M de tokens de entrada y 2,70 $ de salida; stepfun/step-3.7-flash tiene 256.000 tokens y cuesta 0,20 $ de entrada y 1,15 $ de salida.
Tres preguntas deciden la elección: si el prompt con el historial supera los 256.000 tokens, si la salida debe ajustarse a un esquema JSON que tú das y cuánto importa el coste unitario de un turno de agente. Si respondes sí a alguna de las dos primeras, elige Step 5 Preview. Si respondes no a ambas, Step 3.7 Flash acepta el mismo tipo de entrada a un precio por token más bajo.
¿Step 5 Preview o Step 3.7 Flash para trabajo con agentes?
El trabajo de agentes con contexto largo encaja con Step 5 Preview: varios documentos fuente, un historial largo de llamadas a herramientas o archivos elegidos de un repositorio pueden pasar de 256.000 tokens en una sola solicitud. Step 5 Preview lleva la etiqueta Beta en el catálogo.
Los turnos cortos y frecuentes, como resumir la salida de una herramienta, elegir el siguiente paso o interpretar una captura, funcionan con Step 3.7 Flash a un precio unitario más bajo; este modelo lleva la etiqueta Stable. Para una salida atada a un esquema: en el catálogo de LLMTR, json_schema está declarado para Step 5 Preview y json_object para Step 3.7 Flash.
Lado a lado: contexto, precio y funciones
La tabla muestra los valores de ambas filas en el catálogo de LLMTR. Los precios coinciden con la tabla de StepFun y son por 1M de tokens; en los dos modelos los tokens de razonamiento se facturan al precio de salida.
Ambos razonan aunque no envíes reasoning_effort, aceptan low, medium y high y devuelven 400 con xhigh o max. Ambos aceptan imagen y video como data URL en base64 y llaman a herramientas.
| Propiedad | stepfun/step-5-preview | stepfun/step-3.7-flash |
|---|---|---|
| Ventana de contexto | 1.024.000 tokens | 256.000 tokens |
| Entrada | 1,00 $ | 0,20 $ |
| Entrada en caché | 0,10 $ | 0,04 $ |
| Salida (con razonamiento) | 2,70 $ | 1,15 $ |
| reasoning_effort | low, medium, high | low, medium, high |
| Tipos de entrada | texto, imagen, video | texto, imagen, video |
| Llamadas a herramientas | sí | sí |
| Salida JSON | json_object, json_schema | json_object |
| Etiqueta en el catálogo | Beta | Stable |
Cuánto cuesta un turno de agente: un ejemplo
Turno de ejemplo: un prompt de 200.000 tokens, de los que 150.000 están en caché del turno anterior, y 4.000 tokens de salida con el razonamiento incluido. En Step 5 Preview son 50.000 x 1,00 $ / 1M = 0,05 $, 150.000 x 0,10 $ / 1M = 0,015 $ y 4.000 x 2,70 $ / 1M = 0,0108 $, en total 0,0758 $. En Step 3.7 Flash el mismo turno suma 0,01 $ + 0,006 $ + 0,0046 $ = 0,0206 $.
El acierto de caché no está garantizado. Si todo el prompt se factura al precio de entrada, el turno cuesta 0,2108 $ en Step 5 Preview y 0,0446 $ en Step 3.7 Flash. Un prompt de 600.000 tokens solo cabe en la ventana de Step 5 Preview, y su entrada sin caché suma 0,60 $. La cantidad de razonamiento puede variar entre modelos, así que decide con el usage de tus propias solicitudes.
Usar los dos modelos en el mismo agente
Como la clave, la URL base y el formato de los mensajes son los mismos, puedes usar ambos modelos en un solo agente. El ejemplo de Python de abajo elige el modelo según el número estimado de tokens y si hace falta un esquema. El umbral está en 250.000 para dejar espacio a la salida en la ventana de 256.000 tokens de Step 3.7 Flash.
Al cambiar de modelo entre turnos, el historial y las definiciones de herramientas se envían en el mismo formato. Dar los turnos de planificación y lectura de fuentes largas a Step 5 Preview y los resúmenes cortos de resultados a Step 3.7 Flash es un ejemplo de reparto. Compara las respuestas de ambos con las mismas muestras de tu trabajo.
Ejemplo de Python que elige entre stepfun/step-5-preview y stepfun/step-3.7-flash según el número estimado de tokens y la necesidad de un esquema.
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key="llmtr-your_key")

def pick_model(prompt_tokens: int, needs_schema: bool) -> str:
    # Step 3.7 Flash has a 256,000-token window; leave room for the output.
    if prompt_tokens > 250_000 or needs_schema:
        return "stepfun/step-5-preview"
    return "stepfun/step-3.7-flash"

response = client.chat.completions.create(
    model=pick_model(prompt_tokens=12_000, needs_schema=False),
    messages=[{"role": "user", "content": "Summarise the failing test output and propose the next step."}],
    reasoning_effort="low",
    max_tokens=4096,
)
print(response.model, response.choices[0].finish_reason, response.usage)
Empezar con LLMTR: prueba los dos modelos con tu trabajo
Paso 1: crea una cuenta en llmtr.com y recarga crédito prepago. Paso 2: crea una clave en Dashboard > API Keys y guárdala en la variable de entorno LLMTR_API_KEY. Paso 3: envía la misma solicitud a https://llmtr.com/v1 primero con stepfun/step-3.7-flash y luego con stepfun/step-5-preview, y compara el usage de las respuestas.
Cada solicitud se descuenta del crédito al precio del catálogo del modelo usado. Al precio de estos dos modelos no se le añade margen; la comisión de plataforma del 8% de LLMTR se cobra solo al recargar crédito.
Comparar Step 5 Preview y Step 3.7 Flash con tu propio trabajo
Envía la misma solicitud a los dos modelos con una clave de LLMTR y compara las respuestas junto con su usage.
- Clave. Crea una cuenta en llmtr.com, recarga crédito y crea una clave en Dashboard > API Keys.
- Misma solicitud. Envía los mismos mensajes a https://llmtr.com/v1/chat/completions primero con stepfun/step-3.7-flash y luego con stepfun/step-5-preview.
- Comparación. Compara la calidad de las respuestas y los tokens de entrada, caché y salida en usage, y elige el modelo.
Frequently asked questions
¿Cuál es la diferencia de precio entre Step 5 Preview y Step 3.7 Flash?
Por 1M de tokens, Step 5 Preview cuesta 1,00 $ de entrada, 0,10 $ de entrada en caché y 2,70 $ de salida; Step 3.7 Flash cuesta 0,20 $, 0,04 $ y 1,15 $.
¿Step 3.7 Flash produce salida forzada por esquema con JSON Schema?
En el catálogo de LLMTR, la salida forzada por esquema con json_schema está declarada para Step 5 Preview. La salida JSON declarada para Step 3.7 Flash es json_object mediante response_format.
¿Qué cambia en el código para pasar de un modelo al otro?
Solo el nombre del modelo: stepfun/step-5-preview o stepfun/step-3.7-flash. La URL base https://llmtr.com/v1, la clave, el formato de los mensajes y las definiciones de herramientas no cambian.