Gizlilik ve uyum · 2026-10-04
Kolibri Türkçe destekliyor mu? Türkiye'deki ekipler için egemen açık modeller
Aleph Alpha Kolibri yalnızca Almanca ve İngilizce için eğitildi. Bunun Türkçe işler için ne anlama geldiğini, tokenizer etkisini ve açık ağırlığın veri yerleşimine katkısını inceleyin.
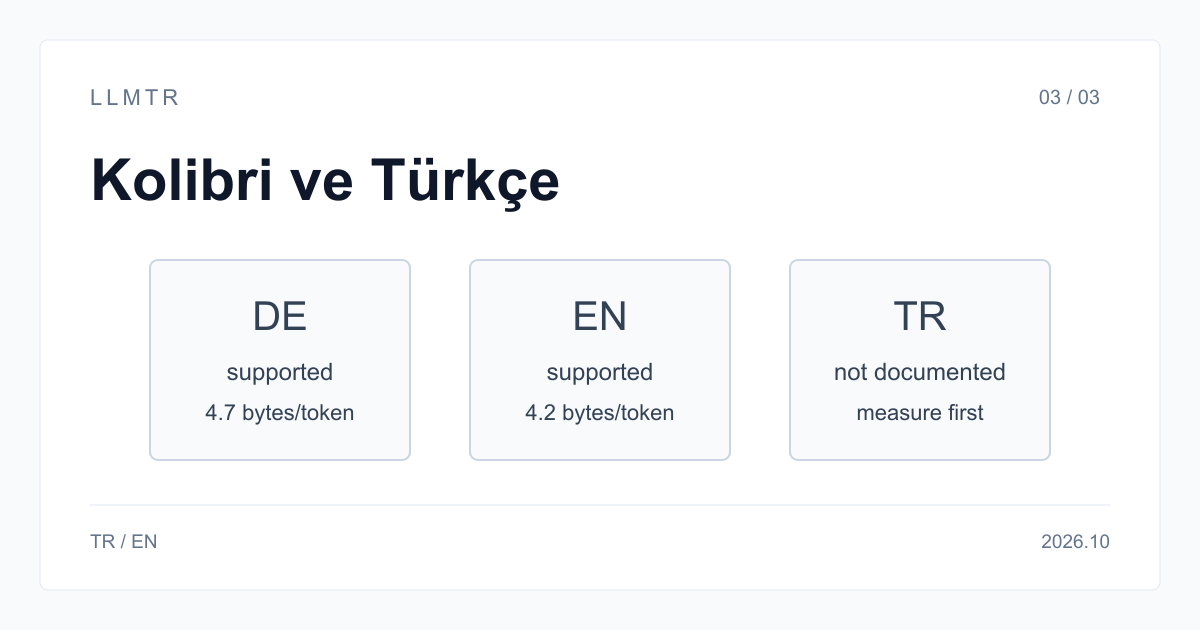
Kısa yanıt: Türkçe resmi olarak desteklenmiyor
Aleph Alpha, Kolibri'yi Almanca ve İngilizce metin işlemek için eğittiğini ve değerlendirdiğini yazıyor. Ön eğitim verisinin yaklaşık yüzde 62,5'i İngilizce, yüzde 23,9'u Almanca, yüzde 13,6'sı koddur. Şirket iki dilde derinleşmeyi, çok dile yayılmaya karşı bilinçli bir tercih olarak tanımlıyor. Türkçe bu dillerden biri değil ve model kartında Türkçe için bir değerlendirme sonucu yok.
Bu, modelin Türkçe metni hiç anlamadığı anlamına gelmez; geniş web verisiyle eğitilen modeller desteklenmeyen dillerde de bir ölçüde metin üretebilir. Ama bu davranış ne üretici tarafından ne de LLMTR tarafından ölçüldü. Kolibri'nin Türkçe kalitesine dair her yargı, sizin kendi örnekleriniz üzerinde yapacağınız ölçüme dayanmalıdır.
Ölçüm için büyük bir veri kümesi gerekmez. Gerçek işinizden alınmış birkaç düzine örnek hazırlayın: tipik sorular, beklenen yanıtlar ve her yanıt için basit bir doğru ya da yanlış ölçütü. Aynı kümeyi Kolibri'de ve Türkçe üzerinde değerlendirilmiş bir modelde çalıştırın. Dil bilgisi hatalarını, Almanca ya da İngilizceye kayan yanıtları ve alan terimlerinin tutarlılığını ayrı ayrı sayın; tek bir genel puan bu farkları gizler.
Dil desteği ve tokenizer
Kolibri'nin tokenizer'ı 128.000 birimlik bir sözlükle ve Almanca kelime yapısını, özellikle birleşik kelimeleri gözeten UniBPE adlı bir yöntemle eğitildi. Token başına düşen bayt arttıkça aynı metin daha az tokena bölünür; bu da hem bağlama sığan metin miktarını hem de token başına ücretlendirilen bir hizmette maliyeti etkiler.
Türkçe de ekler ekleyerek uzun kelimeler kuran bir dildir, ama tokenizer'ın Türkçe metni ne kadar verimli böldüğü yayımlanmadı. Bunu tahmin etmek yerine ölçün: Hugging Face deposundaki tokenizer ile kendi Türkçe belgelerinizden bir örneği tokenlara bölün ve metnin bayt sayısını token sayısına oranlayın. Aynı örneği kullandığınız diğer modellerde de ölçerseniz karşılaştırma anlamlı olur.
| Dil | Model kartındaki durum | Bayt/token (Aleph Alpha) |
|---|---|---|
| Almanca | Eğitildi ve değerlendirildi | 4,7 |
| İngilizce | Eğitildi ve değerlendirildi | 4,2 |
| Türkçe | Belgelenmedi | Yayımlanmadı |
Açık ağırlık veri yerleşimine ne katar?
Kurumlarda yapay zeka tartışmasında genellikle iki soru birbirine karışır: verinin nerede işlendiği ve modelin kime bağlı olduğu. Kolibri ikinci soruya güçlü bir yanıt verir. Ağırlıklar Apache 2.0 ile açık olduğu için model, tek bir sağlayıcının hizmetine bağlı kalmadan seçilen altyapıda çalıştırılabilir; sağlayıcı fiyatını ya da koşullarını değiştirirse taşınabilir bir seçenek elinizde kalır.
Birinci soruyu ise modelin kendisi değil, onu çalıştıran altyapı yanıtlar. Avrupa'da eğitilmiş bir model başka bir ülkede barındırılırsa istekler o ülkede işlenir. KVKK ve kamu düzenlemeleri açısından belirleyici olan modelin nereden geldiği değil, isteğin nerede ve hangi alt işleyici zinciriyle işlendiğidir. Egemen model etiketi bu soruyu sizin yerinize yanıtlamaz.
Kurumsal kullanım için kontrol listesi
Kolibri'yi bir kurum içi projede değerlendirirken şu beş noktayı ayrı ayrı yanıtlayın:
- Görevin dili: İş Almanca ya da İngilizce ise model kartındaki değerlendirmelerin kapsamındadır; Türkçe ise kendi değerlendirme kümenizle ölçmeden üretime almayın.
- Veri yerleşimi: Modelin hangi ülkede çalıştığını, onu sunan altyapıdan ayrıca teyit edin.
- Lisans: Apache 2.0 ticari kullanıma izin verir ve depoda yayımlanan dosyaları kapsar.
- İnsan denetimi: Aleph Alpha modeli, çıktısı uygulanmadan önce bir insanın gözden geçirdiği sistemler için öneriyor.
- Bilgi kesim tarihi: Modelin bilgisi 18 Haziran 2026'da kesilir; daha yeni bilgi için araç çağırma ya da belge ekleme gerekir.
Türkçe ağırlıklı işler için LLMTR'de nereye bakmalı?
Türkçe metnin kalitesi belirleyiciyse, Türkçe üzerinde ayrıca değerlendirilmiş modellerle başlamak daha güvenli bir yoldur. LLMTR kataloğunda modelleri bağlam uzunluğu ve fiyatıyla karşılaştırabilir, Türkiye ya da AB'de barındırılan modelleri ayrı işaretleriyle görebilirsiniz; karşılaştırmayı /models sayfasından yapabilirsiniz.
Kolibri-1, LLMTR API'sinde tesseracted/kolibri-1 kimliğiyle 9 Ekim 2026 23:59'a (TSİ) kadar ücretsiz kullanılabilir; bu tarihten sonra erişim kapanır, model sayfası açık kalır. Almanca ya da İngilizce işlerde Kolibri'yi bu süre içinde mevcut modellerle aynı değerlendirme kümesinde karşılaştırabilirsiniz.
Sık sorulan sorular
Kolibri Türkçe metin üretebilir mi?
Model kartı Türkçeyi desteklenen diller arasında saymıyor ve Türkçe için bir değerlendirme sonucu yayımlamıyor. Üretebileceği metnin kalitesi ölçülmedi; Türkçe bir iş için kullanmadan önce kendi örneklerinizle test edin.
Açık ağırlıklı bir model KVKK uyumunu kendiliğinden sağlar mı?
Hayır. Ağırlıkların açık olması modelin nerede çalıştığını belirlemez. Veri koruma açısından belirleyici olan, isteğin işlendiği altyapı ve bu altyapının alt işleyici zinciridir.
Kolibri LLMTR'de hangi bölgede çalışıyor?
LLMTR'deki Kolibri-1 Tesseracted Labs altyapısında çalışır; sağlayıcı sunucu bölgesini açıklamamıştır, bu yüzden model sayfasında bölge etiketi yoktur. LLMTR'nin Türkiye'de barındırdığı modellerden biri değildir. Sağlayıcının koşullarına göre istem ve yanıt içeriği saklanmaz.