RAG y datos · 2026-10-10
API de embeddings en la UE para un RAG con RGPD
Monta un RAG que tenga en cuenta el RGPD con tensorx/qwen3-embedding-8b-tensorx y un modelo de chat alojado en la UE, desde una sola API compatible con OpenAI.
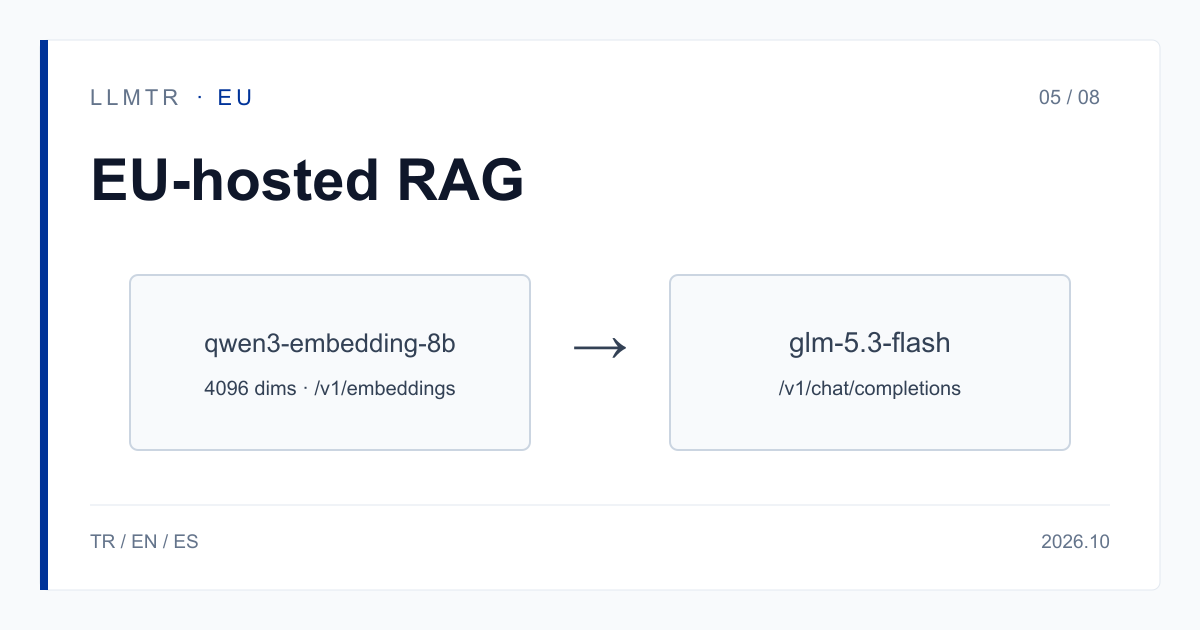
Respuesta corta: embeddings y respuestas en filas alojadas en la UE
LLMTR (llmtr.com) es una pasarela que da acceso a modelos de lenguaje alojados en Turquía y en proveedores globales a través de una única API compatible con OpenAI. Para un RAG, usa tensorx/qwen3-embedding-8b-tensorx para los embeddings y tensorx/glm-5.3-flash-tensorx o tensorx/deepseek-v4-flash-0731-tensorx para las respuestas; todos se llaman desde https://llmtr.com/v1. Para los modelos de esta categoría, el procesamiento dentro de la Unión Europea es lo que declara el proveedor; LLMTR no lo ha verificado de forma independiente.
La fila de embeddings responde en /v1/embeddings, devuelve vectores de 4096 dimensiones y cuesta 0,20 $ por 10 millones de tokens. Las tres son filas de TensorX, así que basta un consentimiento de transferencia de datos de TensorX en tu cuenta. La evaluación del RGPD sigue siendo tuya; este artículo no la sustituye.
¿Cómo montar un RAG que tenga en cuenta el RGPD con una API de embeddings alojada en la UE?
El montaje tiene tres partes: la llamada de embeddings que convierte los documentos en vectores de 4096 dimensiones, tu propio almacén de vectores que guarda los vectores y encuentra el pasaje más cercano a la consulta, y el modelo de chat que lee el pasaje y redacta la respuesta. LLMTR aporta la primera y la tercera parte; el almacén de vectores queda de tu lado.
La fila de embeddings tiene un contexto de 40.960 tokens y cuesta 0,02 $ por 1 millón de tokens de entrada. Vectorizar, por ejemplo, un archivo de 10 millones de tokens cuesta 0,20 $. Según el proveedor, las solicitudes se procesan dentro de la Unión Europea y las entradas no se usan para entrenar modelos. En el momento de la consulta usa la misma fila de embeddings; el vector de la consulta y los de los documentos deben venir de la misma fila.
No mezcles en un mismo índice vectores de dos filas de embeddings distintas. Si cambias de modelo de embeddings, tendrás que volver a vectorizar todo el archivo, así que haz la primera elección antes de escalar.
Pasos del RAG, ids de modelo y precios
La tabla muestra los dos pasos de la cadena y dos opciones de respuesta. Para el paso de respuesta, con 1 millón de tokens de entrada y 100 mil de salida, tensorx/glm-5.3-flash-tensorx cuesta 0,25 $ y tensorx/deepseek-v4-flash-0731-tensorx cuesta 0,28 $. Los precios son los de lista en USD de TensorX; LLMTR no añade nada al precio por token de estas filas.
Los precios cambian según la fila y cada página de modelo muestra el valor actual. GreenPT también tiene filas de embeddings alojadas en la UE; requieren su propio consentimiento de transferencia de datos y sus precios están en la página del modelo.
| Paso del RAG | Id del modelo | Precio por 1 millón de tokens | Nota |
|---|---|---|---|
| Embeddings (documentos y consultas) | tensorx/qwen3-embedding-8b-tensorx | 0,02 $ de entrada | 4096 dimensiones, contexto de 40.960, /v1/embeddings |
| Respuesta (opción 1) | tensorx/glm-5.3-flash-tensorx | 0,20 $ de entrada, 0,50 $ de salida | Contexto de 1.048.576; 1 millón de entrada + 100 mil de salida = 0,25 $ |
| Respuesta (opción 2) | tensorx/deepseek-v4-flash-0731-tensorx | 0,25 $ de entrada, 0,30 $ de salida | Contexto de 1.048.576; 1 millón de entrada + 100 mil de salida = 0,28 $ |
Ejemplo en Python: llamadas de embeddings y de respuesta
El ejemplo siguiente vectoriza dos textos con la fila de embeddings, imprime la longitud del vector y después llama al modelo de chat con un pasaje recuperado. El cliente es el SDK de OpenAI; solo cambian base_url y api_key. El pasaje es un marcador de posición que en un RAG real sacarías de tu almacén de vectores.
Si la cuenta no tiene el consentimiento de TensorX, ambas llamadas devuelven 403 provider_consent_required; la solicitud no llega a TensorX y no se factura.
Ejemplo en Python que vectoriza dos textos con la fila de embeddings y responde con un modelo de chat alojado en la UE.
import os
from openai import OpenAI

client = OpenAI(base_url="https://llmtr.com/v1", api_key=os.environ["LLMTR_API_KEY"])

# Embed two documents with the EU-hosted embedding row (4096 dimensions).
docs = ["Refund requests are answered within 14 days.", "Invoices are sent by e-mail."]
emb = client.embeddings.create(model="tensorx/qwen3-embedding-8b-tensorx", input=docs)
print(len(emb.data[0].embedding))

# Answer with a retrieved passage; the same TensorX consent covers both calls.
passage = "<retrieved passage from your vector store>"
reply = client.chat.completions.create(
    model="tensorx/glm-5.3-flash-tensorx",
    messages=[
        {"role": "system", "content": "Answer only from the passage."},
        {"role": "user", "content": f"Passage: {passage}\n\nQuestion: How long do refunds take?"},
    ],
    max_tokens=300,
)
print(reply.choices[0].message.content)
Datos, consentimiento y evaluación del RGPD
LLMTR no almacena los cuerpos de prompts ni de respuestas; conserva metadatos como el id del modelo, los conteos de tokens, la latencia, el estado HTTP, el coste en USD y los primeros 12 caracteres de la clave. Para los modelos de esta categoría, el procesamiento dentro de la Unión Europea es lo que declara el proveedor; LLMTR no lo ha verificado de forma independiente.
Antes de llamar a filas de TensorX, concede el consentimiento de TensorX en Dashboard > Settings > Data-transfer consents. El consentimiento es de cuenta, cubre todas las claves API y se puede retirar en el mismo lugar. Lo que se transfiere es el contenido de la solicitud; el nombre y el correo no. El consentimiento de GreenPT no cubre las filas de TensorX.
Que un RAG cumpla el RGPD depende de tu base jurídica, de tus contratos de encargo de tratamiento y de la naturaleza de tus documentos, y esa evaluación es responsabilidad tuya. Lee el texto del RGPD y el acuerdo de tratamiento de datos de TensorX antes de decidir.
Empezar en LLMTR: cuenta, consentimiento, clave y primera solicitud
Paso 1: crea una cuenta en llmtr.com, verifica tu correo y recarga crédito desde el Dashboard. Se añade una vez un margen de plataforma del 8 % sobre la cantidad solicitada; una recarga de 10,00 $ cuesta 10,80 $. Después, cada llamada se descuenta al precio del catálogo.
Paso 2: concede en Settings el consentimiento de transferencia de datos de TensorX. Paso 3: crea una clave en Dashboard > API Keys; la clave sin procesar solo se muestra una vez, guárdala como LLMTR_API_KEY. Paso 4: envía la primera solicitud de embeddings a https://llmtr.com/v1 con el código anterior. La misma clave y el mismo saldo sirven para todo el catálogo.
Llamadas de RAG con embeddings alojados en la UE
Completa en cuatro pasos la cuenta y el crédito, el consentimiento de transferencia de TensorX, la clave API y la primera solicitud de embeddings.
- Cuenta y crédito. Crea una cuenta en llmtr.com, verifica tu correo y recarga crédito desde el Dashboard. Se añade una vez un margen de plataforma del 8 %; una recarga de 10,00 $ cuesta 10,80 $.
- Consentimiento de transferencia de TensorX. Concede el consentimiento de TensorX en Dashboard > Settings > Data-transfer consents. Sin él, las solicitudes devuelven 403 provider_consent_required.
- Clave API. Crea una clave en Dashboard > API Keys. La clave sin procesar solo se muestra una vez; guárdala como LLMTR_API_KEY.
- Primera solicitud. Envía la primera solicitud de embeddings con tensorx/qwen3-embedding-8b-tensorx a https://llmtr.com/v1 con cualquier SDK compatible con OpenAI; cambia solo base_url y api_key.
Frequently asked questions
¿Qué id de modelo da una API de embeddings alojada en la UE en LLMTR?
tensorx/qwen3-embedding-8b-tensorx: 4096 dimensiones, contexto de 40.960 y 0,02 $ por 1 millón de tokens de entrada. Según el proveedor, las solicitudes se procesan dentro de la Unión Europea; LLMTR no lo ha verificado de forma independiente.
¿Puedo cambiar el modelo de embeddings más adelante?
Puedes, pero tendrás que volver a vectorizar todo el archivo de documentos con el nuevo modelo. No conviene mezclar en un índice vectores de dos filas de embeddings distintas.
¿Qué significa 403 provider_consent_required?
La cuenta no ha concedido el consentimiento de transferencia de datos de TensorX. Concédelo en Dashboard > Settings > Data-transfer consents; la solicitud no llega a TensorX, por lo que no se factura.